Eine Suchmaschinen-Spinne ist ein automatisiertes Programm – auch Webcrawler, Spider-Bot oder einfach Bot genannt – das systematisch das World Wide Web durchsucht, um Informationen von Webseiten zu entdecken, zu lesen und zu sammeln.
SEO
DigitalMarketing
AffiliateMarketing
WebCrawlers
Spiders
Googles Crawler-Dokumentation
erklärt die von Google verwendeten Crawler- und Fetcher-Kategorien. Nutzen Sie diese Dokumentation, um zu überprüfen, wie ein bestimmter Google-Crawler auf eine Affiliate-Website zugreift.
Eine Suchmaschinen-Spinne ist ein automatisiertes Programm – auch Webcrawler, Spider-Bot oder einfach Bot genannt – das systematisch das World Wide Web durchsucht, um Informationen von Webseiten zu entdecken, zu lesen und zu sammeln. Die von einer Spinne gesammelten Daten werden an eine Suchmaschine zurückgesendet, die sie in einer riesigen Datenbank, dem sogenannten Index, organisiert. Wenn jemand eine Suchanfrage stellt, zieht die Suchmaschine relevante Ergebnisse aus diesem Index – nicht aus dem Live-Web.
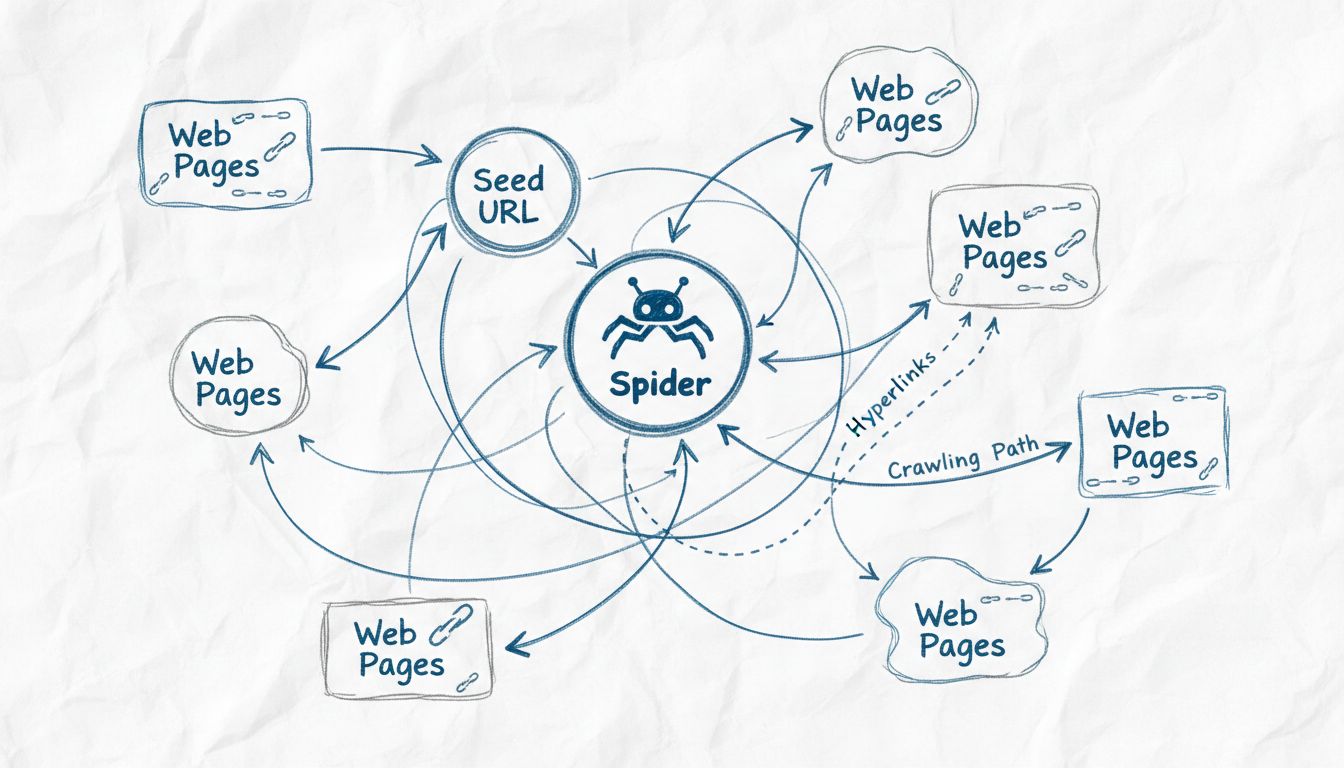
Der Begriff „Spinne“ kommt von der Art und Weise, wie diese Programme das Web durchqueren: Sie folgen Hyperlinks von Seite zu Seite, ähnlich wie eine Spinne sich über die Fäden ihres Netzes bewegt. Der erste bekannte Crawler, WebCrawler, startete 1994 und trug dazu bei, diese Metapher zu etablieren.
Die Kern-Definition
Eine Suchmaschinen-Spinne ist ein automatisiertes Programm – auch Webcrawler, Spider-Bot oder einfach Bot genannt – das systematisch das World Wide Web durchsucht, um Informationen von Webseiten zu entdecken, zu lesen und zu sammeln. Die von einer Spinne gesammelten Daten werden an eine Suchmaschine zurückgesendet, die sie in einer riesigen Datenbank, dem sogenannten Index, organisiert. Wenn jemand eine Suchanfrage stellt, zieht die Suchmaschine relevante Ergebnisse aus diesem Index – nicht aus dem Live-Web.
Der Begriff „Spinne“ kommt von der Art und Weise, wie diese Programme das Web durchqueren: Sie folgen Hyperlinks von Seite zu Seite, ähnlich wie eine Spinne sich über die Fäden ihres Netzes bewegt. Der erste bekannte Crawler, WebCrawler, startete 1994 und trug dazu bei, diese Metapher zu etablieren.
Spinne, Crawler oder Bot – Was ist der Unterschied?
Google verwendet Googlebot, Bing verwendet Bingbot, und beide sind Spinnen, die dieselbe Kernfunktion erfüllen.
Starten Sie noch heute Ihr Affiliate-Programm
Richten Sie erweitertes Tracking in wenigen Minuten ein. Keine Kreditkarte erforderlich.
Das Verständnis des Crawl-Prozesses hilft Website-Betreibern, bessere Entscheidungen über Seitenstruktur, Seitenpriorität und technisches SEO zu treffen.
Start-URLs und Seitenentdeckung
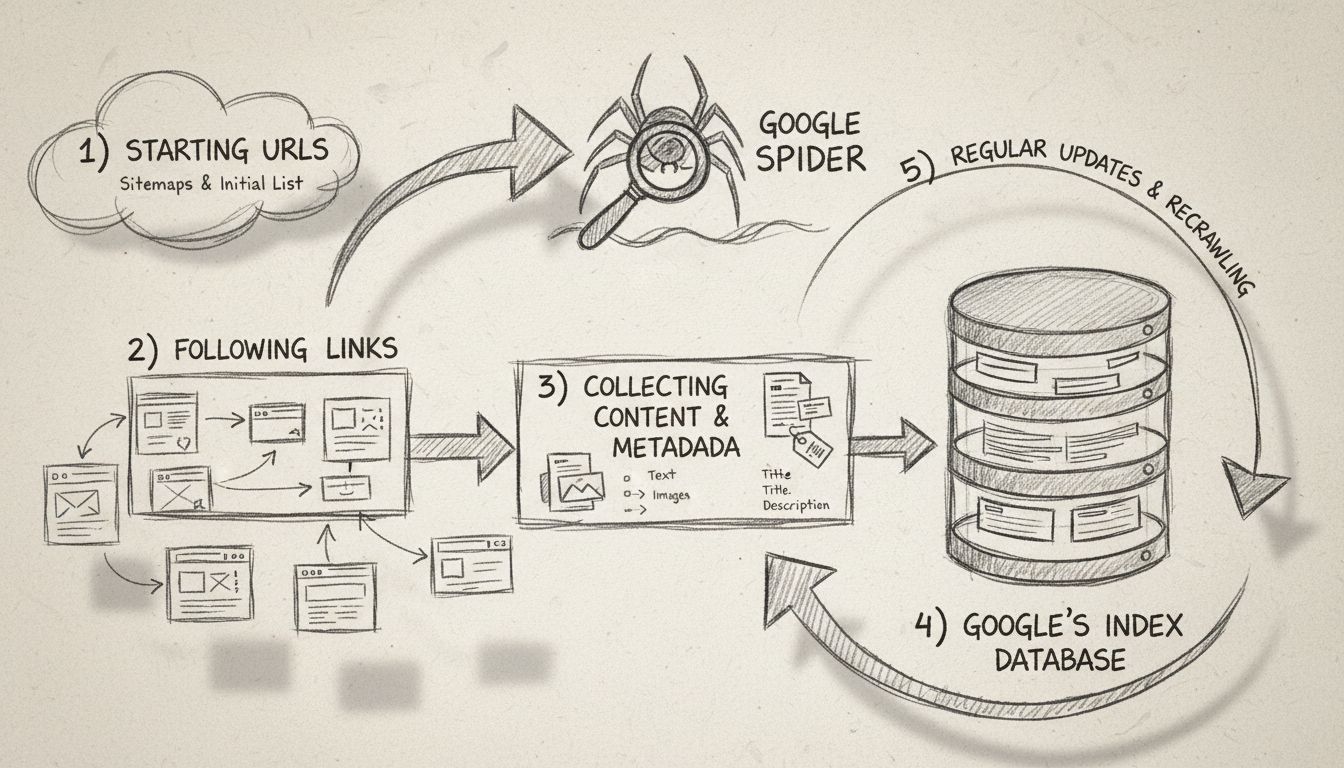
Jede Spinne beginnt mit einer Liste bekannter Webadressen, den sogenannten Start-URLs (Seed URLs). Diese können von zuvor gecrawlten Seiten, eingereichten XML-Sitemaps oder bei früheren Crawls entdeckten Links stammen. Von jeder Start-URL aus lädt die Spinne die Seite herunter und extrahiert jeden darin enthaltenen Hyperlink. Diese Links bilden eine Warteschlange – manchmal auch Crawl-Frontier genannt – der als nächstes zu besuchenden Seiten.
Crawlen, Rendern und Indexieren
Wenn eine Spinne eine Seite erreicht, führt sie drei Schritte aus:
Die Seite anfordern – Die Spinne sendet eine HTTP-Anfrage, genau wie ein Browser. Sie identifiziert sich mit einem User-Agent-Header (z. B. Googlebot/2.1).
Den Inhalt rendern und lesen – Moderne Spinnen, einschließlich Googlebot, rendern JavaScript und verarbeiten das vollständige Document Object Model (DOM). Sie lesen sichtbaren Text, Meta-Tags, Überschriftenstruktur, Bild-Alt-Attribute und strukturierte Datenmarkierungen.
Daten an den Index senden – Die extrahierten Inhalte werden an die Indexierungs-Pipeline der Suchmaschine übergeben, wo sie analysiert, auf Relevanz und Qualität geprüft und für den Abruf gespeichert werden.
Der Crawl-Kreislauf in der Praxis
Der Prozess läuft in einer kontinuierlichen Schleife ab:
Eine URL entdecken → Die Seite abrufen → Inhalt parsen und Links extrahieren → Neue URLs zur Warteschlange hinzufügen → Wiederholen
Eine Spinne überprüft außerdem die robots.txt-Datei, bevor sie eine Seite auf einer Domain crawlt. Wenn die Datei einen Pfad verbietet, überspringt eine wohlerzogene Spinne diesen. Spinnen befolgen auch Meta-Robots-Tags und X-Robots-Tag-HTTP-Header, die ihnen anweisen, eine Seite nicht zu indexieren oder ihren Links nicht zu folgen.
Welche verschiedenen Suchmaschinen-Spinnen gibt es?
Jede große Suchmaschine betreibt ihre eigene Spinne. Hier sind diejenigen, die Ihre Seite am wahrscheinlichsten besuchen:
Spinnen-Name
Suchmaschine
User-Agent-Token
Googlebot
Google
Googlebot
Bingbot
Bing
Bingbot
Slurp Bot
Yahoo (betrieben von Bing)
Slurp
DuckDuckBot
DuckDuckGo
DuckDuckBot
Baiduspider
Baidu (China)
Baiduspider
Yandex Bot
Yandex (Russland)
YandexBot
Applebot
Apple (Siri, Spotlight)
Applebot
Googlebot
Googlebot kommt in zwei Varianten: einem Desktop-Crawler, der einen Desktop-Browser simuliert, und einem Mobile-Crawler, der ein Smartphone simuliert. Seit Google auf Mobile-First-Indexierung umgestellt hat, ist der mobile Googlebot der primäre Crawler für die überwiegende Mehrheit der Websites.
Bingbot, DuckDuckBot und andere
Bingbot betreibt den Bing-Index und beliefert auch Yahoo sowie andere Syndikationspartner mit Ergebnissen. DuckDuckBot crawlt für DuckDuckGo, das seinen eigenen Index mit Ergebnissen von Bing ergänzt. Baiduspider und Yandex Bot bedienen die chinesischen bzw. russischen Märkte und sollten zugelassen werden, wenn Sie Zielgruppen in diesen Regionen haben.
Newsletter abonnieren
Erfahren Sie als Erster von neuen Funktionen und Produkt-Updates.
Was können Suchmaschinen-Spinnen sehen?
Inhalte und HTML, die sie verarbeiten
Suchmaschinen-Spinnen können beim Besuch einer Seite all dies sehen:
Spinnen „sehen“ Seiten nicht so, wie ein Mensch es tut. Inhalte, die in Bildern ohne Alt-Text eingebettet sind, Text, der in komplexem JavaScript gerendert wird, das nicht ausgeführt werden kann, und Inhalte hinter Login-Wänden oder Paywalls sind für die meisten Spinnen unsichtbar. Interaktive Elemente wie Formulare, Dropdowns und Infinite-Scroll-Inhalte, die Benutzerklicks erfordern, können ebenfalls übersehen werden, sofern die Site kein ordnungsgemäßes serverseitiges Rendering oder dynamische Rendering-Techniken verwendet.
Was ist das Crawl-Budget und warum ist es wichtig?
Das Crawl-Budget ist die Anzahl der Seiten, die eine Suchmaschinen-Spinne in einem bestimmten Zeitraum auf Ihrer Website crawlt. Google bestimmt das Crawl-Budget basierend auf zwei Faktoren:
Crawl-Rate-Limit – wie schnell Googlebot Seiten abrufen kann, ohne Ihren Server zu überlasten.
Crawl-Nachfrage – wie sehr Google Ihre Seiten crawlen möchte, gesteuert durch Popularität, Aktualität und die Größe Ihrer Website.
Für große Websites – E-Commerce-Kataloge, Nachrichtenverlage oder Affiliate-Seiten mit tausenden Produktseiten – ist das Crawl-Budget wichtig. Wenn Spinnen Zeit mit minderwertigen URLs (Filterparametern, Session-IDs, doppelten Seiten) verbringen, erreichen sie möglicherweise nicht Ihre wichtigen Inhalte, bevor das Crawl-Fenster schließt.
So optimieren Sie das Crawl-Budget
Blockieren Sie minderwertige URLs in robots.txt (Suchergebnisseiten, gefilterte Ansichten, Admin-Pfade).
Verwenden Sie Canonical-Tags, um doppelte Seiten zu konsolidieren.
Halten Sie Ihre XML-Sitemap sauber und aktuell.
Verbessern Sie die Server-Antwortzeit – schnellere Seiten werden häufiger gecrawlt.
Beheben Sie defekte Links und Redirect-Ketten, die Crawl-Ressourcen verschwenden.
So kontrollieren Sie Suchmaschinen-Spinnen auf Ihrer Website
Sie haben drei Hauptwerkzeuge, um das Verhalten von Spinnen zu steuern.
robots.txt verwenden
Eine robots.txt-Datei, die im Stammverzeichnis Ihrer Domain platziert wird, teilt Spinnen mit, welche Teile Ihrer Website sie besuchen dürfen und welche nicht. Sie verwendet eine einfache Syntax:
Dieses Beispiel blockiert alle Spinnen daran, Pfade unter /admin/ und /search/ zu crawlen. Sie können gezielt bestimmte Spinnen ansprechen, indem Sie deren User-Agent-Token verwenden:
User-agent: Googlebot
Disallow: /private/
Eine robots.txt-Datei ist eine Bitte, kein Befehl. Bösartige Bots können sie ignorieren, aber alle legitimen Suchmaschinen-Spinnen respektieren sie.
Meta-Robots-Tags und X-Robots-Header
Für die Kontrolle auf Seitenebene verwenden Sie den Meta-Robots-Tag im HTML <head>:
<metaname="robots"content="noindex, nofollow">
Dies weist Spinnen an, die Seite nicht zu indexieren und ihren Links nicht zu folgen. Dieselben Anweisungen können als HTTP-Header (X-Robots-Tag) gesendet werden, was für Nicht-HTML-Dateien wie PDFs nützlich ist.
XML-Sitemaps
Eine XML-Sitemap listet die URLs auf, die Sie von Spinnen priorisiert haben möchten. Reichen Sie sie über die Google Search Console oder die Bing Webmaster Tools ein. Eine Sitemap garantiert kein Crawling, hilft Spinnen jedoch dabei, neue und aktualisierte Seiten schneller zu entdecken – insbesondere auf Websites mit tiefer Architektur oder begrenzter interner Verlinkung.
Webcrawler vs. Webscraper – Was ist der Unterschied?
Die Begriffe werden oft verwechselt, beschreiben jedoch unterschiedliche Zwecke:
Aspekt
Webcrawler (Spinne)
Webscraper
Zweck
Seiten für die Suche entdecken und indexieren
Spezifische Daten aus Seiten extrahieren
Betreiber
Suchmaschinen (Google, Bing)
Einzelpersonen, Unternehmen, Forscher
Umfang
Breit – das gesamte erreichbare Web
Gezielt – bestimmte Websites oder Datenpunkte
Ausgabe
Ein durchsuchbarer Index
Strukturierte Daten (CSV, Datenbank, API)
Respektiert robots.txt
Ja (legitime)
Variiert; viele Scraper ignorieren es
Eine Spinne erstellt die Karte; ein Scraper schürft im Terrain. Beide sind automatisiert, verfolgen jedoch grundlegend unterschiedliche Ziele. Einige Tools wie der Screaming Frog SEO Spider verwischen die Grenze – sie crawlen wie eine Spinne, werden aber für Site-Audits und nicht für die Suchindexierung verwendet.
Sind Web-Spinnen schädlich?
Nicht grundsätzlich. Legitime Suchmaschinen-Spinnen sind nützlich – ohne sie würde Ihre Website nicht in den Suchergebnissen erscheinen. Allerdings sind nicht alle Bots freundlich.
Gute Bots vs. Schlechte Bots
Gute Bots identifizieren sich klar, respektieren robots.txt, crawlen in angemessenem Tempo und bieten Mehrwert (Sichtbarkeit in der Suche, Website-Überwachung, Archivierung).
Schlechte Bots können Inhalte zur Wiederveröffentlichung scrapen, nach Sicherheitslücken suchen, Credential-Stuffing versuchen oder Ihren Server mit übermäßigen Anfragen belasten.
Anzeichen für schädliche Bot-Aktivitäten sind:
Spitzen in der Serverlast durch unbekannte User-Agents
Inhalte, die ohne Quellenangabe auf anderen Websites erscheinen
Crawl-Traffic zu Seiten, die nicht erlaubt sein sollten
Wiederholte Anfragen an Login-Seiten oder Formulare
So schützen Sie Ihre Website
Überprüfen Sie Server-Logs auf verdächtige User-Agent-Strings und IP-Bereiche.
Verwenden Sie ein CDN oder eine Web Application Firewall (WAF) mit Bot-Management-Funktionen.
Blockieren Sie bekannte schlechte Bots in robots.txt – auch wenn bösartige sie ignorieren, hilft es bei einigen.
Begrenzen Sie die Rate aggressiver Crawler auf Server- oder CDN-Ebene.
Ist ChatGPT ein Webcrawler?
OpenAIs GPTBot ist ein Webcrawler, der Trainingsdaten für KI-Modelle sammelt. Es ist keine Suchmaschinen-Spinne – es betreibt keinen öffentlichen Suchindex.
User-agent: GPTBot
Disallow: /
Ebenso können Anthropics ClaudeBot und Google-Extended (für Googles KI-Training verwendet, getrennt von Googlebot) über denselben Mechanismus gesteuert werden. Diese Crawler beeinflussen Ihre Suchmaschinen-Platzierungen nicht – das Blockieren schadet Ihrem SEO nicht.
Welche Suchmaschine verfolgt Sie nicht?
Wenn Sie sich um Privatsphäre sorgen, sind DuckDuckGo und Brave Search die beiden großen Suchmaschinen, die Benutzer nicht verfolgen oder persönliche Profile erstellen. Beide betreiben eigene Spinnen (DuckDuckBot und Braves Crawler) und ergänzen ihre Indizes mit Ergebnissen aus anderen Quellen. Sie verwenden kontextbezogene Schlüsselwörter anstelle des Benutzerverlaufs, um Ergebnisse zu ordnen, was bedeutet, dass das On-Page-SEO Ihrer Website für die Sichtbarkeit auf diesen Plattformen noch wichtiger ist.
Spinnen und Affiliate-Marketing – Warum es wichtig ist
Suchmaschinen-Spinnen betreffen direkt jede Rolle im Affiliate-Marketing-Ökosystem.
Für Werbetreibende (Marken mit Affiliate-Programmen)
Ihre Affiliate-Programm-Landingpages, Bedingungsseiten und Werbeinhalte müssen crawlbar und indexierbar sein. Wenn Spinnen Ihre Programminformationen nicht erreichen können, werden potenzielle Affiliates, die nach „[Ihre Marke] Affiliate-Programm“ suchen, Sie möglicherweise nicht organisch finden. Wichtige Schritte:
Stellen Sie sicher, dass Ihre Affiliate-Anmeldeseite in Ihrer XML-Sitemap enthalten und nicht durch robots.txt blockiert ist.
Verwenden Sie saubere URL-Strukturen – vermeiden Sie Session-IDs und unnötige Parameter, die doppelte Seiten erzeugen und Crawl-Budget verschwenden.
Überwachen Sie die Google Search Console auf Crawl-Fehler auf Ihren wichtigen Conversion-Seiten.
Für Publisher (Affiliates)
Jede Produktbewertung, jeder Vergleichsartikel und jeder Leitfaden, den Sie veröffentlichen, hängt davon ab, über die Suche gefunden zu werden – und das bedeutet, gecrawlt und indexiert zu werden. Spinnen sind die Torwächter. Best Practices:
Interne Verlinkung ist wichtig: Spinnen folgen Links. Ein gut verlinkter Artikel-Cluster signalisiert Wichtigkeit und hilft Spinnen, neue Inhalte schneller zu entdecken.
Aktualität löst erneutes Crawlen aus: Die Aktualisierung vorhandener Inhalte und die Änderung des lastmod-Datums in Ihrer Sitemap kann Spinnen dazu veranlassen, Ihre Seiten früher erneut zu besuchen.
Vermeiden Sie dünne Affiliate-Seiten: Seiten mit wenig originellem Inhalt und vielen Affiliate-Links können von Suchalgorithmen als minderwertig eingestuft werden. Spinnen crawlen sie zwar, aber sie werden möglicherweise nicht gut platziert – oder gar nicht.
Für Affiliate-Programm-Manager
Das Verständnis des Spinnenverhaltens hilft Ihnen, Ihre Affiliates besser zu unterstützen:
Wenn die Inhalte eines Affiliates nicht ranken, liegt das Problem möglicherweise an technischen Hürden – überprüfen Sie, ob seine Seiten indexiert sind (verwenden Sie die site:-Suche) und ob er Spinnen unbeabsichtigt blockiert.
Wenn Sie Ihre Affiliate-Plattform migrieren oder URLs ändern, verwenden Sie 301-Weiterleitungen und aktualisieren Sie Ihre Sitemap umgehend. Spinnen folgen den Weiterleitungen und aktualisieren den Index, wodurch der Linkwert Ihrer Affiliates erhalten bleibt.
Crawl-Budget-Überlegungen gelten für große Affiliate-Seiten mit tausenden Produktseiten. Helfen Sie Affiliates zu verstehen, welche Seiten sie in ihren Sitemaps priorisieren sollten.
Häufig gestellte Fragen
Suchmaschinen-Spinnen durchsuchen systematisch das Web, laden Seiteninhalte herunter und folgen Links, um neue Seiten zu entdecken. Sie senden die gesammelten Daten an eine Suchmaschine zurück, die sie in einem Index organisiert, der für die Beantwortung von Suchanfragen verwendet wird.
Eine Spinne startet mit einer Liste bekannter URLs (Startadressen), lädt jede Seite herunter, extrahiert deren Inhalt und Links und fügt neue URLs ihrer Crawl-Warteschlange hinzu. Sie überprüft vor dem Crawlen die robots.txt-Regeln, rendert den Seiteninhalt und übergibt die Daten an die Indexierungs-Pipeline. Dieser Prozess wiederholt sich kontinuierlich.
Die wichtigsten Arten sind Suchmaschinen-Crawler (Googlebot, Bingbot), Site-Audit-Crawler (Screaming Frog, Sitebulb), Archivierungs-Crawler (Bot des Internet Archive) und Data-Scraping-Crawler, die für Preisüberwachung, Forschung oder KI-Training eingesetzt werden. Nur Suchmaschinen-Crawler wirken sich direkt auf Ihre Suchmaschinen-Platzierungen aus.
Veröffentlichen Sie regelmäßig neue Inhalte, aktualisieren Sie bestehende Seiten, reichen Sie eine präzise XML-Sitemap über die Google Search Console ein, verbessern Sie die Seitenladegeschwindigkeit und bauen Sie interne Links von bereits indexierten Seiten zu neuen Inhalten auf. Seiten mit hoher Autorität und häufigen Aktualisierungen werden öfter gecrawlt.
Webcrawler indexieren Seiten für Suchmaschinen; Webscraper extrahieren spezifische Daten für andere Zwecke (Preisanalyse, Lead-Generierung, Forschung). Crawler sind breit angelegt und explorativ; Scraper sind zielgerichtet. Legitime Crawler respektieren robots.txt; Scraper tun dies oft nicht.
Legitime Suchmaschinen-Spinnen sind nicht schädlich – sie sind essenziell, damit Ihre Seite in den Suchergebnissen erscheint. Bösartige Bots jedoch, die robots.txt ignorieren, Inhalte scrapen, nach Sicherheitslücken suchen oder Server überlasten, können schädlich sein. Verwenden Sie Server-Log-Überwachung und Bot-Management-Tools, um schlechte Bots zu erkennen und zu blockieren.
Das Crawl-Budget ist die Anzahl der Seiten, die eine Suchmaschinen-Spinne in einem bestimmten Zeitraum auf Ihrer Website crawlt. Google bestimmt es durch die Abwägung zwischen der Geschwindigkeit, mit der gecrawlt werden kann, ohne den Server zu beeinträchtigen (Crawl-Rate-Limit), und dem Interesse, Ihre Seiten zu crawlen (Crawl-Nachfrage). Die meisten kleinen Seiten müssen sich darüber keine Gedanken machen.
Verwenden Sie einen noindex-Meta-Robots-Tag oder X-Robots-Tag-HTTP-Header auf Seiten, die Sie nicht im Index haben möchten. Blockieren Sie das Crawlen sensibler Verzeichnisse über robots.txt. Für ganze Websites in der Entwicklung verwenden Sie eine passwortgeschützte Staging-Umgebung oder geben Sie einen site-weiten noindex-Befehl bis zum Launch aus.
Reichen Sie eine XML-Sitemap über die Google Search Console und die Bing Webmaster Tools ein. Stellen Sie sicher, dass Seiten nicht durch robots.txt oder noindex-Tags blockiert werden. Bauen Sie interne Links von bereits indexierten Inhalten zu neuen Seiten. Verwenden Sie das URL-Inspektionstool in der Search Console, um die Indexierung einzelner URLs anzufordern.
Steigern Sie Ihr Affiliate-Marketing mit SEO-Erkenntnissen
Entdecken Sie, wie das Verständnis von Web-Spinnen Ihnen helfen kann, Ihre Seite für bessere Suchergebnisse und höhere Affiliate-Einnahmen zu optimieren.
Was ist der Google Spider? Vollständiger Leitfaden zum Crawling durch Googlebot
Erfahren Sie, was der Google Spider (Googlebot) ist, wie er Websites crawlt und indexiert und warum er für SEO unerlässlich ist. Entdecken Sie, wie Sie Ihre Web...
Warum werden Webcrawler Spinnen genannt? Verständnis der Web-Indexierungstechnologie
Erfahren Sie, warum Webcrawler Spinnen genannt werden, wie sie funktionieren und welche entscheidende Rolle sie bei der Indexierung von Suchmaschinen spielen. E...
+++ term = “Was ist ein Suchmaschinen-Crawler?” lastmod = “2026-10-08” title = “Was ist ein Suchmaschinen-Crawler?” keywords...
18 Min. Lesezeit
SEO
Crawlers
+4
Sie sind in guten Händen!
Treten Sie unserer Gemeinschaft zufriedener Kunden bei und bieten Sie exzellenten Kundensupport mit Post Affiliate Pro.