

Suchmaschinen-Spinne
Eine Suchmaschinen-Spinne ist ein automatisierter Bot, der Webseiten durchsucht, um Inhalte für Suchmaschinen wie Google und Bing zu indexieren. Erfahren Sie, w...
10 Min. Lesezeit
SEO
DigitalMarketing
+3
Spider-Erkennung ist der Prozess zur Identifizierung automatisierter Softwareprogramme – Spiders, Webcrawler oder Bots genannt – die eine Webseite besuchen, und zur Bestimmung, ob diese einen legitimen Zweck erfüllen oder eine Bedrohung für die Datenintegrität, Werbeausgaben oder Affiliate-Programm-Einnahmen darstellen.
Spider-Erkennung ist der Prozess zur Identifizierung automatisierter Softwareprogramme – Spiders, Webcrawler oder Bots genannt – die eine Webseite besuchen, und zur Bestimmung, ob jeder einzelne einen legitimen Zweck erfüllt oder eine Bedrohung für die Datenintegrität, Werbeausgaben oder Affiliate-Programm-Einnahmen darstellt.
Spider-Erkennung ist eine Disziplin der Sicherheit und Analytik, die automatisierte HTTP-Clients identifiziert, indem sie deren technische Signaturen, Verhaltensmuster und Netzwerkmerkmale untersucht. Der Begriff „Spider" (Spinne) leitet sich davon ab, wie diese Programme das Web durchkriechen – Hyperlinks von Seite zu Seite folgend, wie eine Spinne ihr Netz durchläuft.
In der Praxis beantwortet Spider-Erkennung für jeden Besucher eine Frage: Ist dies ein Mensch, ein freundlicher Bot oder ein bösartiges Skript? Die Antwort bestimmt, ob der Besuch in Ihrer Analytik gezählt wird, ob der Klick eine Provision auslöst und ob der Lead in Ihr CRM gelangt.
Die drei Begriffe werden oft synonym verwendet, haben jedoch je nach Kontext unterschiedliche Bedeutungen:
Nicht jeder automatisierte Traffic ist feindselig. Effektive Spider-Erkennung unterscheidet zwischen Kategorien:
| Bot-Kategorie | Beispiele | Sollten Sie blockieren? |
|---|---|---|
| Suchmaschinen-Crawler | Googlebot, Bingbot, YandexBot | Nein – Blockieren entfernt Sie aus den Suchergebnissen |
| SEO- und Marketing-Tools | AhrefsBot, SemrushBot, Moz Dotbot | Fallabhängig – sie verbrauchen Ressourcen, können aber die Sichtbarkeit fördern |
| Überwachung und Validierung | IAB Tech Lab Crawler, Uptime-Monitore | Nein – sie überprüfen ads.txt, SSL und die Seitengesundheit |
| Content-Scraper | Unidentifizierte Bots, die Ihre Inhalte kopieren | Ja – sie stehlen Inhalte und bieten keinen Mehrwert |
| Klickbetrug-Bots | Skripte, die Affiliate-Links oder Anzeigen anklicken | Ja – sie stehlen direkt aus Ihrem Budget |
| Lead-Betrug-Bots | Automatisierte Formularausfüller, die gefälschte Anmeldungen einreichen | Ja – sie verschwenden CPA-Ausgaben und verunreinigen Ihr CRM |
| Credential-Stuffer | Bots, die gestohlene Anmeldedaten testen | Ja – sie stellen eine Sicherheitsbedrohung dar |
Die Grenze zwischen „gut" und „schlecht" ist nicht immer scharf. Ein SEO-Crawler eines legitimen Tools kann dennoch Ihre Analytik verzerren, wenn Sie seine Besuche als menschlichen Traffic zählen. Spider-Erkennung liefert Ihnen die Daten, um fundierte Entscheidungen zu treffen – nicht nur, um alles wahllos zu blockieren.

Richten Sie erweitertes Tracking in wenigen Minuten ein. Keine Kreditkarte erforderlich.
Moderne Spider-Erkennung kombiniert mehrere Signale. Keine einzelne Prüfung ist für sich allein zuverlässig – raffinierte Bots fälschen User-Agents, rotieren IPs und imitieren menschliches Verhalten. Effektive Erkennung schichtet mehrere Methoden übereinander.
Jede HTTP-Anfrage enthält einen User-Agent-Header, der den Client identifiziert, der die Anfrage stellt. Legitime Crawler geben sich offen zu erkennen:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Mozilla/5.0 (compatible; Bingbot/2.0; +http://www.bing.com/bingbot.htm)
Einschränkung: Jeder Bot kann vorgeben, Googlebot zu sein, indem er dessen User-Agent-Zeichenfolge kopiert. Die User-Agent-Analyse ist ein erster Filter, keine abschließende Prüfung.
Die zuverlässige Methode zur Überprüfung einer behaupteten Crawler-Identität ist der Abgleich der IP-Adresse. Bei großen Suchmaschinen funktioniert der Prozess wie folgt:
*.googlebot.com für Googlebot).Wenn alle vier Schritte übereinstimmen, ist der Crawler authentisch. Google, Bing und Yandex veröffentlichen ihre IP-Bereiche und Verifikationsmethoden. Jeder Bot, der vorgibt, Googlebot zu sein, aber von einer AWS-Rechenzentrums-IP aus verbindet, wird sofort markiert.
Menschen surfen unvorhersehbar. Sie machen Pausen zwischen Seitenaufrufen, scrollen mit unterschiedlichen Geschwindigkeiten und klicken in Mustern, die sich nur schwer programmatisch nachbilden lassen. Bots hinterlassen andere Spuren:
Verhaltenssignale sind schwieriger zu fälschen als Header oder IPs. Sie zwingen den Bot-Betreiber dazu, menschliche Interaktion zu simulieren, was die Kosten und die Komplexität des Angriffs so weit erhöht, dass viele Betrüger abgeschreckt werden.
Geräte-Fingerprinting sammelt Attribute des verbindenden Clients – Browserversion, installierte Schriftarten, Bildschirmauflösung, WebGL-Renderer und Dutzende anderer Signale – um eine eindeutige Kennung zu erstellen. Wenn derselbe Fingerprint bei Hunderten von „verschiedenen" Besuchern auftaucht oder wenn ein Fingerprint nicht zum angegebenen User-Agent passt, markieren Spider-Erkennungssysteme den Traffic.
| Methode | Was wird geprüft | Stärke | Schwäche |
|---|---|---|---|
| User-Agent-Analyse | Browser-/Client-Identifikationszeichenfolge | Schnell, kostenloser erster Filter | Leicht fälschbar |
| IP-/Reverse-DNS-Verifikation | Netzwerkursprung und Hostname-Übereinstimmung | Abschließend für bekannte Crawler | Funktioniert nur für deklarierte Bots |
| Verhaltensanalyse | Anfragezeitpunkt, Navigationsmuster | Schwer in großem Maßstab zu fälschen | Erfordert Sitzungsdaten |
| Geräte-Fingerprinting | Browser- und Hardware-Merkmale | Starkes Betrugssignal | Datenschutzbestimmungen können greifen |
| JavaScript-Challenges | Fähigkeit zur Ausführung von Skripten | Blockiert einfache Skripte | Legitime Crawler führen möglicherweise kein JS aus |
| Honeypot-Fallen | Versteckte Links, denen nur Bots folgen | Hochzuverlässige Bot-Erkennung | Erfordert Seiteninstrumentierung |
Affiliate-Programme zahlen Partnern für Leistung – Klicks, Leads oder Verkäufe. Jedes betrügerische Ereignis, das als legitim gezählt wird, kostet echtes Geld. Spider-Erkennung ist die erste Verteidigungslinie gegen mehrere Kategorien von Affiliate-Betrug.
Klickbetrug ist der direkteste Angriff auf Affiliate-Budgets. Ein Bot simuliert Klicks auf Affiliate-Links und bläht die Klickmetriken auf, ohne dass eine menschliche Interaktion stattfindet. Der Affiliate wird für Traffic bezahlt, der nie eine Konversionschance hatte.
Spider-Erkennung fängt Klickbetrug, indem sie die automatisierten Muster hinter den Klicks identifiziert: Rechenzentrums-IPs, wiederholte Klicks von identischen Geräte-Fingerprints und Klickgeschwindigkeiten, die kein Mensch erzeugen könnte.
In Cost-per-Lead (CPL)-Affiliate-Programmen reichen Bots gefälschte Anmeldeformulare ein, um Provisionsauszahlungen auszulösen. Diese Leads sehen auf den ersten Blick echt aus – sie haben Namen, E-Mail-Adressen und Telefonnummern – aber sie konvertieren nie weiter.
Spider-Erkennung markiert gefälschte Leads, indem sie prüft, ob die Einreichung von einer Rechenzentrums-IP, einem gefälschten Gerät oder einer Wegwerf-E-Mail-Domain stammt – Signale, die ein menschlicher Nutzer selten produziert.
Cookie-Stuffing ist eine heimtückischere Form des Betrugs. Ein Skript platziert Affiliate-Tracking-Cookies ohne Wissen des Nutzers in dessen Browser – oft durch ein Pop-Under, ein 1×1-Pixel-Bild oder ein Skript, das in eine kompromittierte Seite eingeschleust wird. Wenn der Nutzer später einen Kauf tätigt, beansprucht der Betrüger die Provision.
Spider-Erkennung identifiziert die automatisierten Skripte, die Cookie-Stuffing durchführen, anhand ihrer Verhaltenssignatur: schnelle, unsichtbare Anfragen, die Cookies setzen, ohne einen entsprechenden Seitenbesuch oder eine Nutzerinteraktion.
Über den direkten finanziellen Verlust hinaus verunreinigt Bot-Traffic jede Kennzahl, auf die Sie sich verlassen. Konversionsraten sinken, weil Bot-Traffic den Nenner aufbläht. Die Kampagnenleistung wird unlesbar. Marketingteams optimieren auf Kohorten, die nie existiert haben.
Eine saubere Spider-Erkennung stellt das Vertrauen in Ihre Daten wieder her. Wenn Sie Bot-Traffic herausfiltern, bevor er in Ihre Analytik gelangt, sehen Sie, was Ihre menschlichen Nutzer tatsächlich tun – und können Entscheidungen auf Basis der Realität treffen.
Erfahren Sie als Erster von neuen Funktionen und Produkt-Updates.
Das Interactive Advertising Bureau (IAB) Tech Lab unterhält die branchenweit maßgebliche Referenz für Spider-Erkennung: die IAB/ABC International Spiders and Bots List. Sie ist die Grundlage, auf die die meisten ernsthaften Betrugspräventionssysteme aufbauen.
Die Liste besteht aus zwei Textdateien, die regelmäßig aktualisiert werden:
Das IAB schreibt eine zweistufige Methode vor, die in seinen Ad Impression Measurement Guidelines definiert ist:
Diese Zwei-Stufen-Methode ist der Standard für die MRC-akkreditierte Erkennung ungültigen Traffics (IVT). Sie stellt sicher, dass deklarierte Crawler herausgefiltert werden, während unbekannte Bots nicht einfach durchrutschen, nur weil sie auf keiner Liste stehen.
Der Zugang erfordert eine unterzeichnete Datenabonnementvereinbarung und wird über das Tech Lab Tools Portal bereitgestellt. Ein Login pro abonnierendem Unternehmen. Für die meisten Affiliate-Programm-Manager erfolgt der Zugriff auf die Liste indirekt – über die Betrugserkennungsplattform oder das Analysetool, das sie bereits nutzen und das die Liste in ihrem Namen lizenziert.
Diese integrierten Systeme filtern Bot-Traffic automatisch aus Ihren Berichten, sodass Klicks und Konversionen, die bekannten Crawlern zugeschrieben werden, niemals in Ihre Provisionsberechnungen einfließen.
Der Vorteil der plattformseitigen Erkennung ist, dass keine Einrichtung erforderlich ist – sie funktioniert sofort, wird vom Anbieter gewartet und ist mit der IAB-Liste integriert.
Für Programme mit höherem Betrugsrisiko – hohe CPA-Auszahlungen, großes Traffic-Volumen oder Branchen, die von Betrugsringen ins Visier genommen werden – bieten spezielle Betrugspräventionsplattformen zusätzliche Schichten über die grundlegende Spider-Erkennung hinaus:
Auch ohne spezielle Plattform können Programm-Manager mehrere Signale manuell überwachen:
Eine Spider-Falle ist eine Reihe dynamisch generierter Seiten, die eine Endlosschleife für Webcrawler erzeugen. Häufige Beispiele sind:
Ein legitimer Crawler, der auf eine Spider-Falle trifft, kann sein Crawl-Budget – die Anzahl der Seiten, die er Ihrer Seite zuweist – aufbrauchen, indem er Tausende von nahezu identischen Seiten indexiert, während er Ihre tatsächlichen Inhalte verpasst.
Spider-Fallen schaden Ihrer Seite auf zweierlei Weise. Erstens verschwenden sie Crawl-Budget: Googlebot verwendet sein Kontingent für bedeutungslose URLs anstatt für Ihre Produktseiten und Blogbeiträge. Zweitens können sie die Serverleistung beeinträchtigen, wenn Crawler dynamisch generierte Seiten in hoher Frequenz anfordern.
Die Lösung ist einfach: Verwenden Sie robots.txt, um das Crawlen fallenanfälliger URL-Muster zu verbieten, fügen Sie rel="canonical"-Tags hinzu, um doppelte Seiten zu konsolidieren, und vermeiden Sie die Bereitstellung unendlicher URL-Räume durch interne Verlinkung. Spider-Erkennungssysteme können auch erkennen, wenn ein bekannter Crawler in einer Falle steckt, und seinen Zugriff entsprechend drosseln.
Sichern Sie Ihre Affiliate-Kampagnen und Datenintegrität mit fortschrittlichen Spider-Erkennungstools und Betrugspräventionsstrategien.
Eine Suchmaschinen-Spinne ist ein automatisierter Bot, der Webseiten durchsucht, um Inhalte für Suchmaschinen wie Google und Bing zu indexieren. Erfahren Sie, w...
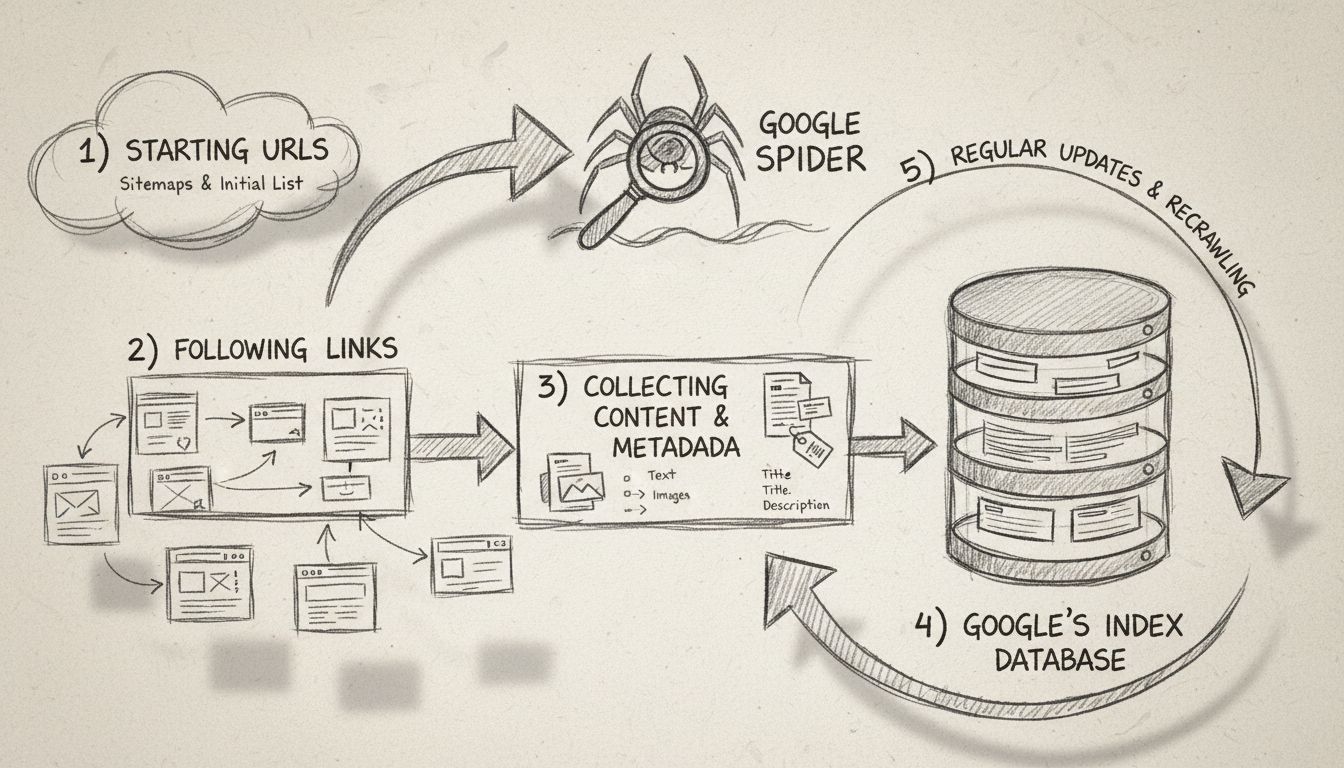
Erfahren Sie, was der Google Spider (Googlebot) ist, wie er Websites crawlt und indexiert und warum er für SEO unerlässlich ist. Entdecken Sie, wie Sie Ihre Web...
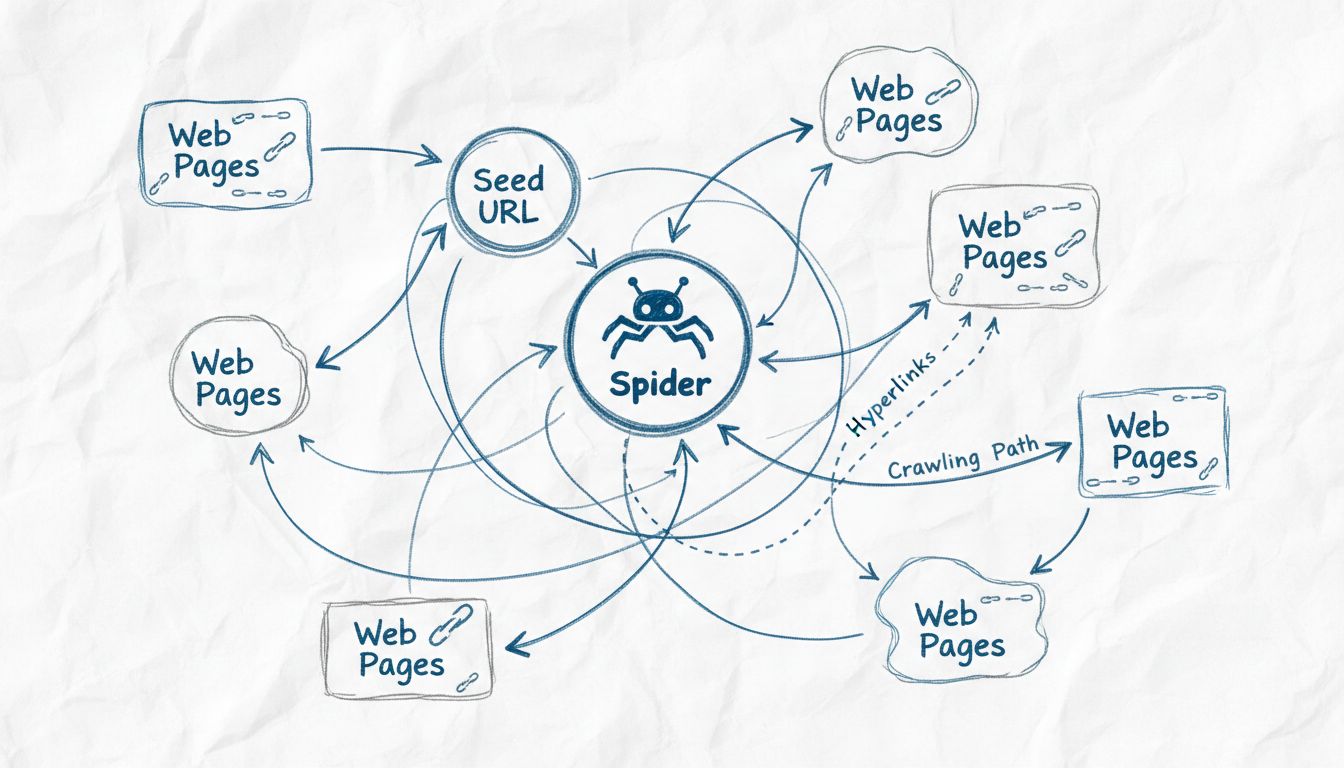
Erfahren Sie, warum Webcrawler Spinnen genannt werden, wie sie funktionieren und welche entscheidende Rolle sie bei der Indexierung von Suchmaschinen spielen. E...
Treten Sie unserer Gemeinschaft zufriedener Kunden bei und bieten Sie exzellenten Kundensupport mit Post Affiliate Pro.
Cookie-Zustimmung
Wir verwenden Cookies, um Ihr Surferlebnis zu verbessern und unseren Datenverkehr zu analysieren. See our privacy policy.