


Was ist eine Suchmaschinen-Spinne?
Eine Suchmaschinen-Spinne ist ein automatisierter Bot, der Webseiten durchsucht, um Inhalte für Suchmaschinen wie Google und Bing zu indexieren. Erfahren Sie, w...
10 Min. Lesezeit
SEO
DigitalMarketing
+3
+++ term = “Was ist ein Suchmaschinen-Crawler?” lastmod = “2026-10-08” title = “Was ist ein Suchmaschinen-Crawler?” keywords = [ “suchmaschinen-ranking”, “suchmaschine”, “suchmaschinen-ranking”, “suchmaschinenoptimierung”, “rolle bei der suche”, “crawler”, “suche”, “suchmaschine” ] url = “/affiliatemarketing-glossar/crawler/” aliases = [ “/affiliate-marketing-glossary/crawlers/” ] description = “Erfahren Sie, wie Suchmaschinen-Crawler Webseiten entdecken und indizieren und warum dies für SEO wichtig ist.” date = “2024-11-07 11:14:13” image = "" shortDescription = “Ein Suchmaschinen-Crawler ist ein automatisiertes Softwareprogramm – auch Bot, Spider oder Spiderbot genannt – das systematisch das World Wide Web durchsucht, Seiteninhalte herunterlädt und Hyperlinks folgt, um neue oder aktualisierte URLs zu entdecken.” tags = [ “SEO”, “Crawlers”, “Indexing”, “AffiliateMarketing”, “SearchEngines”, “TechnicalSEO” ] categories = [ “Glossary” ] showCTA = true ctaHeading = “Optimieren Sie Ihre Website für Suchmaschinen” ctaDescription = “Erfahren Sie, wie das Verständnis und die Optimierung für Crawler die Sichtbarkeit Ihrer Website und das Suchmaschinen-Ranking verbessern kann.” ctaPrimaryText = “SEO-Tipps erhalten” ctaPrimaryURL = “/blog/” ctaSecondaryText = “Post Affiliate Pro testen” ctaSecondaryURL = “/trial/”
[[faq]] question = “Können Sie mir ein Beispiel für einen Web-Crawler nennen?” answer = “Googlebot ist das bekannteste Beispiel. Es ist der primäre Web-Crawler von Google, verantwortlich für die Entdeckung und Indexierung von Milliarden von Seiten im Web. Weitere Beispiele sind Bingbot (Microsoft Bing), DuckDuckBot (DuckDuckGo), YandexBot (Yandex) und Baiduspider (Baidu). Auf der KI-Seite sind GPTBot von OpenAI und Claude-Web von Anthropic Crawler, die öffentlich zugängliche Daten für das Training von Modellen sammeln.”
[[faq]] question = “Was ist das Crawl-Budget und warum ist es wichtig?” answer = “Das Crawl-Budget ist die Anzahl der Seiten, die eine Suchmaschine innerhalb eines bestimmten Zeitraums auf einer Website crawlt. Es wird bestimmt durch die Crawl-Ratenbegrenzung (wie schnell die Suchmaschine Seiten abrufen kann, ohne die Leistung zu beeinträchtigen) und die Crawl-Nachfrage (wie stark die Suchmaschine eine Website crawlen möchte, basierend auf Popularität und Aktualität). Große Websites mit Tausenden von Seiten müssen ihr Crawl-Budget sorgfältig verwalten – wenn es für Duplikatinhalte, Facettennavigation-URLs oder Fehlerseiten verschwendet wird, bleiben hochwertige Seiten möglicherweise unbesucht.”
[[faq]] question = “Wie kann ich überprüfen, ob meine Website gecrawlt wurde?” answer = “Die zuverlässigsten Methoden sind:
[[faq]] question = “Kann ich einen Crawler blockieren, ohne mein SEO zu beeinträchtigen?” answer = “Ja. Verwenden Sie robots.txt-Direktiven, die auf bestimmte User-Agents abzielen. Das Blockieren von GPTBot hat beispielsweise keine Auswirkungen auf Googlebot, Bingbot oder andere Such-Crawler. Der Schlüssel liegt in der Spezifität – verwenden Sie User-agent: GPTBot (nicht User-agent: ), wenn Sie einen einzelnen Crawler blockieren möchten, während Sie den Zugriff von Suchmaschinen intakt lassen. Testen Sie robots.txt-Änderungen immer zuerst in der Google Search Console, bevor Sie sie live schalten.”
[[faq]] question = “Wie werden Crawler von KI-Unternehmen wie OpenAI eingesetzt?” answer = “KI-Unternehmen setzen Crawler wie GPTBot ein, um öffentlich zugängliche Webdaten für das Training großer Sprachmodelle zu sammeln und Live-Informationsabfragen zu ermöglichen. Diese Crawler folgen denselben grundlegenden Mechanismen wie Suchmaschinen-Crawler – sie rufen Seiten ab, folgen Links und respektieren robots.txt –, ihr Zweck ist jedoch das Modelltraining und nicht die Suchindexierung.”
[[lnks]] text = “Mobile-First-Indexierung” path = “/blog/mobile-friendliness-affiliate-marketing/” title = “Warum Mobile-Freundlichkeit ein echter Ranking- und Umsatzfaktor im Affiliate-Marketing ist – von Core Web Vitals bis zu responsivem Design – und wie Sie Ihre Affiliate-Site für Mobilgeräte testen und optimieren.”
[[lnks]] text = “Webseiten-Crawler” path = “/faq/why-are-web-crawlers-called-spiders/” title = “Erfahren Sie, warum Web-Crawler Spinnen genannt werden, wie sie funktionieren und welche entscheidende Rolle sie bei der Suchmaschinen-Indexierung spielen. Entdecken Sie die technischen Mechanismen hinter dem Web-Crawling im Jahr 2025.”
[[lnks]] text = “Budget für jede” path = “/blog/optimize-affiliate-marketing-budget/” title = “Sechs umsetzbare Strategien zur Optimierung Ihres Affiliate-Marketing-Budgets, einschließlich der Nutzung sozialer Medien und der Zusammenarbeit mit Nischen-Influencern.”
[[lnks]] text = “Frische und relevante Inhalte” path = “/faq/keep-content-fresh-engaging/” title = “Entdecken Sie wirksame Strategien, um Ihre Inhalte frisch und ansprechend zu halten. Erfahren Sie mehr über Inhaltsformate, Analysen, Zielgruppenbindung und professionelle Schreibtchniken, um das Interesse Ihres Publikums aufrechtzuerhalten und im Affiliate-Marketing erfolgreich zu sein.”
[[lnks]] text = “Affiliate-Vermarkter” path = “/faq/what-makes-affiliate-marketing-content-rank-well/” title = “Entdecken Sie die wesentlichen Faktoren, die Affiliate-Marketing-Inhalte in Suchmaschinen gut ranken lassen. Lernen Sie bewährte SEO-Strategien, Content-Optimierungstechniken und Best Practices, um die Sichtbarkeit und Conversion-Rate Ihrer Affiliate-Site zu steigern.”
[[lnks]] text = “Keyword-Optimierung” path = “/faq/how-to-do-on-page-seo/” title = “Erfahren Sie, wie Sie On-Page-SEO mit Title-Tags, Meta-Beschreibungen, Überschriften, Keywords und Content-Strategien optimieren. Meistern Sie die technische On-Page-Optimierung, um die Suchrankings mit dem umfassenden Leitfaden von PostAffiliatePro zu verbessern.”
[[lnks]] text = “Affiliate-Vermarkter” path = “/blog/top-keyword-research-tools-for-affiliate-marketers/” title = “Welche Keyword-Recherche-Tools sollten Affiliate-Vermarkter verwenden, um ihre Inhalte bei Google höher zu ranken? Lesen Sie diesen Artikel, um es herauszufinden!”
[[lnks]] text = “Affiliate-Links typischerweise” path = “/affiliate-marketing-glossary/seo-affiliates/” title = “SEO-Affiliates, auch Such-Affiliates genannt, helfen Ihnen, das Ranking Ihrer Website auf der Suchergebnisseite zu verbessern. Entdecken Sie, wie SEO-Affiliates mit Expertenstrategien organischen Traffic generieren und den Affiliate-Marketing-Erfolg steigern.”
[[lnks]] text = “Web-Crawler” path = “/faq/how-do-web-crawlers-work/” title = “Erfahren Sie, wie Web-Crawler funktionieren – von Seed-URLs bis zur Indexierung. Verstehen Sie den technischen Prozess, Crawler-Typen, robots.txt-Regeln und wie Crawler SEO und Affiliate-Marketing beeinflussen.”
[[lnks]] text = “SEO beeinflussen” path = “/faq/why-are-sitemaps-important/” title = “Erfahren Sie, warum Sitemaps für den SEO-Erfolg entscheidend sind. Entdecken Sie, wie XML- und HTML-Sitemaps die Crawlbarkeit, Indexierung und Sichtbarkeit in Suchmaschinen für Ihre Website verbessern.”
[[lnks]] text = “Suchmaschinen” path = “/faq/how-to-identify-search-engine-crawlers/” title = “Erfahren Sie, wie Sie Suchmaschinen-Crawler anhand von User-Agent-Strings, IP-Adressen, Anfragemustern und Verhaltensanalysen identifizieren. Ein wesentlicher Leitfaden für Webmaster und Entwickler.”
[[lnks]] text = “entscheidend für die Suche” path = “/faq/what-is-google-spider/” title = “Erfahren Sie, was Google Spider (Googlebot) ist, wie es Websites crawlt und indexiert und warum es für SEO unverzichtbar ist. Entdecken Sie, wie Sie Ihre Site für besseres Crawling optimieren.” +++ Ein Suchmaschinen-Crawler ist ein automatisiertes Softwareprogramm – auch Bot, Spider oder Spiderbot genannt – das systematisch das World Wide Web durchsucht, Seiteninhalte herunterlädt und Hyperlinks folgt, um neue oder aktualisierte URLs zu entdecken. Seine Kernaufgabe ist es, den Index einer Suchmaschine mit aktuellen Daten zu versorgen, damit die Suchmaschine bei einer Suchanfrage relevante und aktuelle Ergebnisse liefern kann. Ohne Crawler hätte eine Suchmaschine keine Möglichkeit zu erfahren, dass eine Seite überhaupt existiert.
Der Crawler selbst bewertet nichts. Er entdeckt Seiten und übergibt das Gefundene – Text, Links, Metadaten, Bilder – an ein separates Indexierungs- und Ranking-System. Crawling, Indexierung und Ranking sind drei unterschiedliche Phasen. Eine Seite kann gecrawlt werden und dennoch nie in den Suchergebnissen erscheinen, wenn sie die Qualitätsschwellen der Suchmaschine während der Indexierung nicht erfüllt.
Googles Crawler-Dokumentation unterscheidet zwischen allgemeinen Crawlern, speziellen Crawlern und nutzerausgelösten Abrufwerkzeugen. Überprüfen Sie die dokumentierte Identität und das Verhalten des betreffenden Crawlers, wenn Sie Zugriffsprobleme untersuchen.
Auf dieser Seite
Ein Web-Crawler arbeitet in einer Endlosschleife, die auf wenigen Kernschritten basiert. Das Verständnis dieser Schritte hilft Website-Betreibern zu diagnostizieren, warum Seiten möglicherweise nicht in den Suchergebnissen erscheinen – das Problem liegt oft bereits in der Crawling-Phase, lange bevor das Ranking überhaupt eine Rolle spielt.
Jeder Crawler beginnt mit einem Satz bekannter URLs, den sogenannten Seed-URLs. Diese können aus zuvor gecrawlten Seiten, eingereichten Sitemaps oder manuell ausgewählten Startpunkten stammen. Der Crawler lädt jede Seed-Seite herunter, extrahiert alle darin gefundenen Hyperlinks und fügt jeden noch nicht gesehenen Link einer Warteschlange hinzu, der Crawl-Frontier.
Der Zyklus wiederholt sich dann:
Diese Schleife endet nie wirklich. Das Web verändert sich ständig, und jede Sekunde erscheinen neue Seiten. Ein Crawler arbeitet sich daher einfach durch das Nächste in der Warteschlange, besucht alte Seiten erneut, um Änderungen zu prüfen, und fügt neu entdeckte URLs hinzu.
Sobald ein Crawler eine Seite abruft, rendert er den Inhalt – liest das HTML, führt nach Möglichkeit JavaScript aus und extrahiert Text, Bilder, Metadaten und strukturierte Daten. Anschließend lädt er diese Informationen herunter und übergibt sie an den Indexer der Suchmaschine.
Nicht jeder Crawler verarbeitet JavaScript gleich gut. Googlebot rendert JavaScript und wartet auf dynamisch geladene Inhalte, aber kleinere Suchmaschinen-Crawler lesen möglicherweise nur statisches HTML. Deshalb können Websites, die vollständig mit clientseitigen JavaScript-Frameworks erstellt wurden, für manche Suchmaschinen unsichtbar sein, sofern kein serverseitiges Rendering eingerichtet ist.
Crawler entdecken neue Seiten über zwei Hauptkanäle:

Richten Sie erweitertes Tracking in wenigen Minuten ein. Keine Kreditkarte erforderlich.
Crawler behandeln nicht alle Seiten gleich. Sie arbeiten nach einem Satz von Crawl-Richtlinien, die bestimmen, welche Seiten sie besuchen, in welcher Reihenfolge und wie oft sie zurückkehren.
Ein Crawler muss entscheiden, welche URLs aus seiner Crawl-Frontier priorisiert werden. Häufige Signale sind:
Wie oft ein Crawler zu einer Seite zurückkehrt, hängt davon ab, wie häufig sich diese Seite ändert. Eine Nachrichten-Startseite wird möglicherweise alle paar Minuten gecrawlt. Eine statische „Über uns“-Seite wird vielleicht nur alle paar Monate erneut besucht. Webmaster können die Änderungshäufigkeit über XML-Sitemap-<changefreq>-Tags signalisieren, wobei Suchmaschinen diese als Hinweise und nicht als Anweisungen behandeln.
Crawler sind so programmiert, dass sie Webserver nicht überlasten. Sie respektieren eine Crawl-Ratenbegrenzung – die maximale Anzahl von Anfragen, die sie innerhalb eines bestimmten Zeitraums an eine einzelne Website senden. Wenn ein Server mit HTTP-Fehlern wie 500 oder 503 antwortet, zieht sich der Crawler zurück, um das Problem nicht zu verschlimmern. Dies ist ein Grund, warum Crawling im großen Maßstab eine echte technische Herausforderung darstellt.
Die robots.txt-Datei ist ein Textdokument, das im Stammverzeichnis einer Domain platziert wird und Crawlern mitteilt, welche URLs sie anfordern dürfen und welche nicht. Es ist das mit Abstand wichtigste Werkzeug zur Verwaltung des Crawler-Zugriffs. Ein robots.txt-Eintrag könnte wie folgt aussehen:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ überspringen, aber alles unter /public/ zulassen soll. Andere Crawler überprüfen dieselbe Datei und folgen ihren eigenen User-agent-Anweisungen. Es ist erwähnenswert, dass robots.txt ein freiwilliges Protokoll ist – gut erzogene Crawler befolgen es, aber bösartige Bots können es vollständig ignorieren.Das Crawl-Budget ist die Anzahl der Seiten, die eine Suchmaschine innerhalb eines bestimmten Zeitrahmens auf einer Website crawlt. Es wird durch zwei Faktoren bestimmt:
Für kleine Websites ist das Crawl-Budget selten ein Problem. Für große E-Commerce-Plattformen oder Content-Seiten mit Millionen von URLs wird die Verwaltung des Crawl-Budgets jedoch essenziell – verschwendete Crawls auf Duplikatinhalte, Facettennavigation-Parameter oder minderwertige Seiten bedeuten weniger Ressourcen für die Seiten, die wirklich zählen.
Jede große Suchmaschine betreibt ihren eigenen Crawler mit einem eindeutigen User-Agent-String – eine Kennung, die der Bot mit jeder HTTP-Anfrage sendet, damit Server wissen, welcher Crawler zu Besuch ist.
| Suchmaschine | Crawler-Name | User-Agent-Kennung | Zweck |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Crawlt und indexiert Webseiten für die Google-Suche und andere Google-Dienste | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Crawlt und indexiert Seiten für Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Crawlt Seiten für die Suchergebnisse von DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Crawlt Seiten für die Yandex-Suche (dominant in Russland) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Crawlt Seiten für die Baidu-Suche (dominant in China) |
| Apple | Applebot | Applebot/1.0 | Crawlt Seiten für die Spotlight-Suche und Siri-Vorschläge |
Google betreibt auch spezialisierte Crawler für verschiedene Inhaltstypen – Googlebot Image crawlt Bilder, Googlebot Video verarbeitet Videoinhalte, Googlebot News zielt auf Nachrichtenartikel ab, und AdsBot überprüft die Qualität von Landingpages für Google Ads.
Erfahren Sie als Erster von neuen Funktionen und Produkt-Updates.
Die Identifizierung, ob ein Besucher wirklich Googlebot ist, erfordert mehr als nur die Überprüfung eines User-Agent-Strings, da diese Strings gefälscht werden können. So überprüfen Sie einen Google-Crawler:
Googlebot.googlebot.com- oder google.com-Domain auflösen.Google stellt eine offizielle Dokumentation mit seinen IP-Bereichen unter google.com/bot.html zur Verfügung. Jeder Besucher, der behauptet, Googlebot zu sein, aber diese Überprüfungsschritte nicht besteht, ist ein gefälschter Bot und sollte als verdächtig behandelt werden.
Ja – jedoch mit Einschränkungen. Große Suchmaschinen betreiben spezielle Crawler für Nicht-Text-Inhalte:
VideoObject-Schema, um Titel, Beschreibung, Vorschaubild und Dauer zu erfassen.Allerdings können Crawler Bilder nicht so „sehen“ wie ein Mensch oder Videos „ansehen“. Sie verlassen sich vollständig auf Textsignale – Dateinamen, Alt-Attribute, Bildunterschriften, umgebenden Fließtext und strukturierte Daten –, um die Relevanz zu bestimmen. Inhalte hinter Login-Wänden, Paywalls oder in komplexen JavaScript-Playern werden möglicherweise überhaupt nicht gecrawlt.
Diese Begriffe werden oft synonym verwendet, beschreiben aber unterschiedliche Dinge:
| Aspekt | Web-Crawler | Web-Scraper |
|---|---|---|
| Zweck | URLs im gesamten Web entdecken und indexieren | Spezifische Daten von Zielseiten extrahieren |
| Umfang | Breit – folgt Links überallhin | Eng – zielt auf bekannte URLs oder Domains |
| Ausgabe | Speist einen Suchindex | Produziert strukturierte Daten (CSV, Datenbank, Tabellenkalkulation) |
| Typischer Betreiber | Suchmaschinen (Google, Bing) | Unternehmen, Forscher, Datenanalysten |
| Respektiert robots.txt | Ja (legitime Crawler) | Variiert – viele Scraper ignorieren es |
| Beispiele | Googlebot, Bingbot | Preisüberwachungstools, Lead-Generierungs-Scraper, KI-Trainingsdatensammler |
Suchmaschinen finden neue Seiten über mehrere Kanäle:
Der schnellste Weg, eine neue Seite crawlen zu lassen, ist die direkte Einreichung ihrer URL über die Search Console und die Sicherstellung, dass sie von einer bereits indexierten Seite derselben Website verlinkt ist.
Es gibt keinen festen Zeitplan. Die Wiederbesuchshäufigkeit hängt ab von:
Website-Betreiber können die Wiederbesuchshäufigkeit beeinflussen, indem sie regelmäßig Inhalte veröffentlichen, schnelle Server-Antwortzeiten aufrechterhalten und aktualisierte Sitemaps einreichen. Letztendlich entscheidet der Crawler jedoch selbst über seinen Zeitplan basierend auf den von ihm beobachteten Signalen.
Crawler haben im Allgemeinen keinen Zugriff auf:
Ein Crawler sieht nur, was öffentlich zugänglich und verlinkt ist. Wenn eine Seite zur Darstellung eine Authentifizierung oder Benutzerinteraktion erfordert, ist sie für Suchmaschinen praktisch unsichtbar – es sei denn, der Website-Betreiber gewährt explizit Zugriff oder bietet einen alternativen Pfad, wie z. B. eine Sitemap mit der URL in Kombination mit strukturierten Daten, die den Inhalt beschreiben.
Einen Crawler zu bauen, der für ein paar hundert Seiten funktioniert, ist unkompliziert. Einen zu bauen, der für Milliarden funktioniert, ist ein völlig anderes Problem. Häufige Fehlerpunkte sind:
Für die meisten Unternehmen ist der Betrieb eines groß angelegten Web-Crawlers ohne verwaltete Infrastruktur nicht praktikabel. Die Entscheidung läuft in der Regel darauf hinaus, ein vorhandenes Tool zu verwenden, anstatt eines von Grund auf neu zu entwickeln.
In den Vereinigten Staaten ist das Crawlen öffentlich zugänglicher Seiten im Allgemeinen legal. Mehrere Gerichtsurteile – darunter hiQ Labs v. LinkedIn – haben bestätigt, dass das Crawlen öffentlicher Daten unter bestimmten Umständen legal sein kann.
Die Legalität hängt jedoch von mehreren Faktoren ab:
Die Unterscheidung zwischen Crawling zur Suchindexierung (weithin akzeptiert) und Scraping zur kommerziellen Datenextraktion (rechtlich umstrittener) ist wichtig. Die meisten legitimen Suchmaschinen-Crawler bewegen sich in eindeutig legalem Terrain.
Nein – ChatGPT selbst ist kein Web-Crawler. ChatGPT ist ein dialogbasiertes KI-Modell, das Antworten generiert. OpenAI betreibt jedoch einen separaten Web-Crawler namens GPTBot, der öffentliche Webseiten crawlt, um Trainingsdaten für KI-Modelle zu sammeln und Live-Abruffunktionen in einigen OpenAI-Produkten zu unterstützen.
GPTBot identifiziert sich mit dem User-Agent-Token GPTBot und respektiert robots.txt-Anweisungen. Website-Betreiber, die GPTBot gezielt blockieren möchten, können ihrer robots.txt-Datei Folgendes hinzufügen:
User-agent: GPTBot
Disallow: /
Suchmaschinen-Crawler betreffen direkt alle Teilnehmer des Affiliate-Marketing-Ökosystems. Wenn eine Seite nicht gecrawlt wird, rankt sie nicht, und wenn sie nicht rankt, generiert sie keinen organischen Traffic – und keine Affiliate-Einnahmen.
Die Content-Site eines Publishers steht und fällt mit der Crawlbarkeit. Jede Produktbewertung, jeder Vergleichsleitfaden oder jede Angebotsübersicht muss von Crawlern auffindbar sein. Häufige Publisher-Fehler, die das Crawling blockieren, sind:
Publisher sollten überprüfen, ob ihre wertvollsten Seiten im Index-Coverage-Bericht der Google Search Console erscheinen und dass keine noindex-Tags oder robots.txt-Regeln sie versehentlich blockieren.
Ein Werbetreibender, der ein Affiliate-Programm betreibt, benötigt gecrawlte und indexierte Produktseiten, damit Publisher auf live sichtbare Seiten verlinken können. Wenn die Produktseiten eines Händlers nicht im Google-Index sind, haben Publisher keine Möglichkeit, Traffic dorthin zu senden. Zu den spezifischen Risiken gehören:
Händler sollten saubere URL-Strukturen pflegen, Produkt-Sitemaps einreichen und die Crawl-Statistiken in der Search Console überwachen, um Probleme zu erkennen, bevor sie Publisher-Partner betreffen.
Programm-Manager stehen zwischen Händlern und Publishern und sollten das Crawler-Verhalten verstehen, um Sichtbarkeitsprobleme zu beheben. Wenn ein Publisher meldet, dass die Produktseite eines Händlers „bei Google nicht angezeigt wird“, liegt das Problem oft beim Crawling oder der Indexierung – nicht beim Ranking. Praktische Schritte sind:
site:, ob die Seite indexiert ist.Ein Programm-Manager, der grundlegende Crawl-Probleme diagnostizieren kann, stiftet auf beiden Seiten der Affiliate-Beziehung direkten Mehrwert – indem er Händlern hilft, technische Probleme zu beheben, und Publishern bestätigt, dass die von ihnen beworbenen Seiten auffindbar sind.
Verwalten Sie mehrere Affiliate-Programme und verbessern Sie die Leistung Ihrer Affiliate-Partner mit Post Affiliate Pro.
Eine Suchmaschinen-Spinne ist ein automatisierter Bot, der Webseiten durchsucht, um Inhalte für Suchmaschinen wie Google und Bing zu indexieren. Erfahren Sie, w...
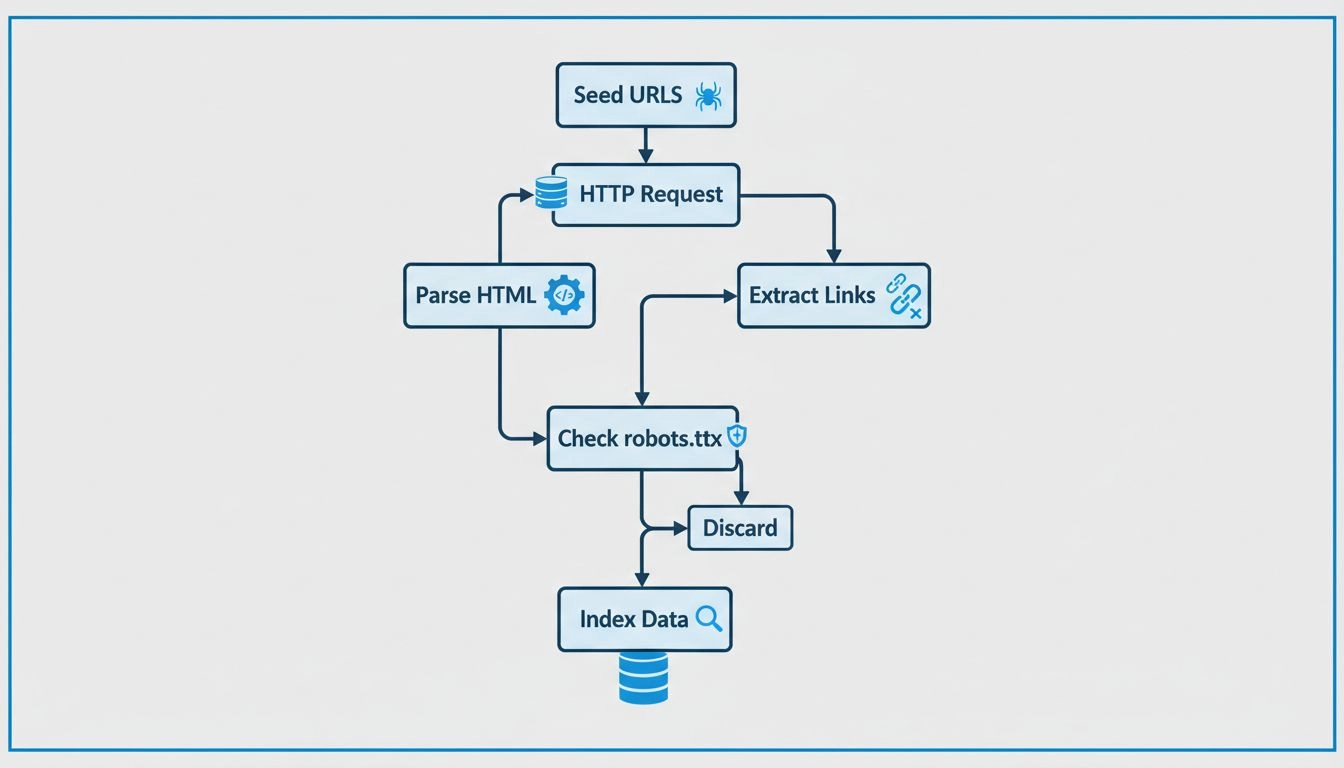
Erfahren Sie, wie Webcrawler arbeiten – von Seed-URLs bis zur Indexierung. Verstehen Sie den technischen Ablauf, Crawler-Typen, robots.txt-Regeln und wie Crawle...
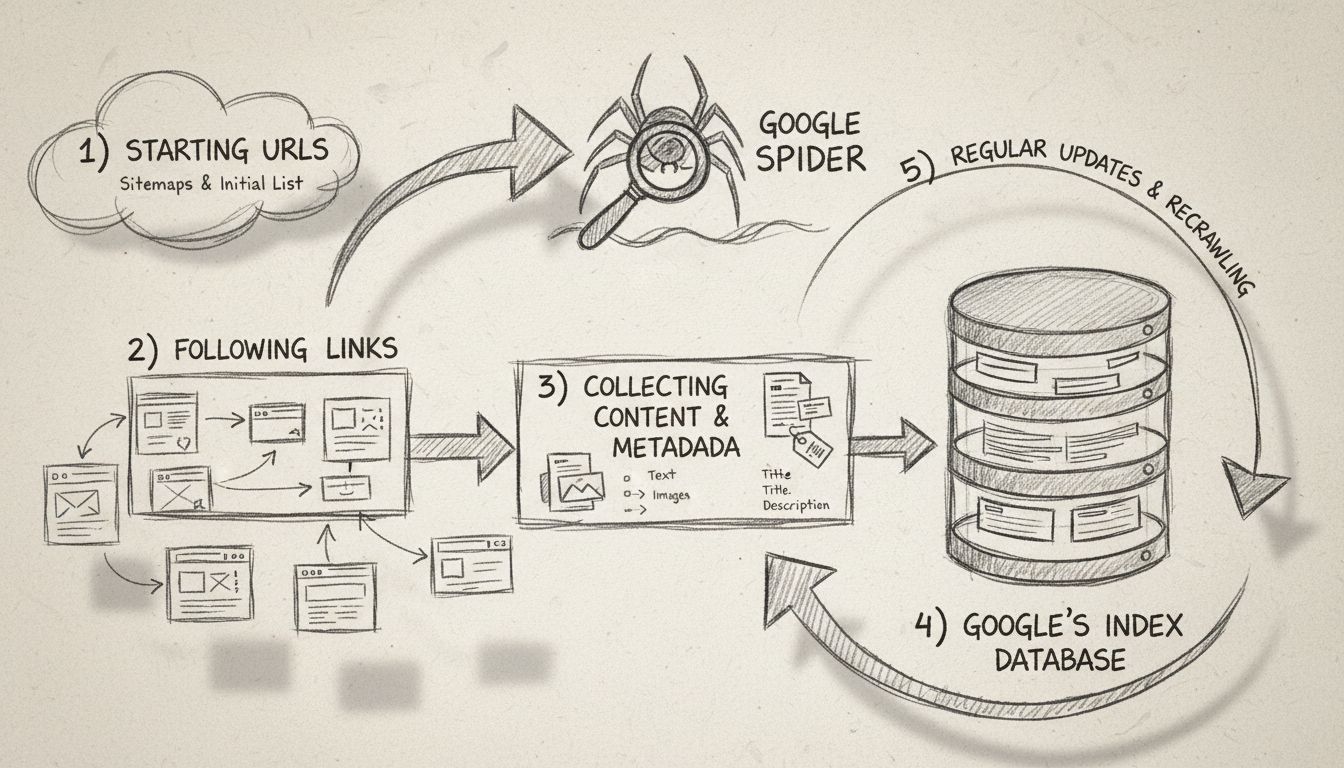
Erfahren Sie, was der Google Spider (Googlebot) ist, wie er Websites crawlt und indexiert und warum er für SEO unerlässlich ist. Entdecken Sie, wie Sie Ihre Web...
Treten Sie unserer Gemeinschaft zufriedener Kunden bei und bieten Sie exzellenten Kundensupport mit Post Affiliate Pro.


Cookie-Zustimmung
Wir verwenden Cookies, um Ihr Surferlebnis zu verbessern und unseren Datenverkehr zu analysieren. See our privacy policy.