


Suchmaschinen-Spinne
Eine Suchmaschinen-Spinne ist ein automatisierter Bot, der Webseiten durchsucht, um Inhalte für Suchmaschinen wie Google und Bing zu indexieren. Erfahren Sie, w...
10 Min. Lesezeit
SEO
DigitalMarketing
+3
Ein Suchmaschinen-Crawler ist ein automatisiertes Softwareprogramm – auch Bot, Spider oder Spiderbot genannt – das systematisch das World Wide Web durchsucht, Seiteninhalte herunterlädt und Hyperlinks folgt, um neue oder aktualisierte URLs zu entdecken.
Ein Suchmaschinen-Crawler ist ein automatisiertes Softwareprogramm – auch Bot, Spider oder Spiderbot genannt – das systematisch das World Wide Web durchsucht, Seiteninhalte herunterlädt und Hyperlinks folgt, um neue oder aktualisierte URLs zu entdecken. Seine Kernaufgabe ist es, den Index einer Suchmaschine mit aktuellen Daten zu versorgen, damit die Suchmaschine bei einer Suchanfrage relevante und aktuelle Ergebnisse liefern kann. Ohne Crawler hätte eine Suchmaschine keine Möglichkeit zu erfahren, dass eine Seite überhaupt existiert.
Der Crawler selbst bewertet nichts. Er entdeckt Seiten und übergibt das Gefundene – Text, Links, Metadaten, Bilder – an ein separates Indexierungs- und Ranking-System. Crawling, Indexierung und Ranking sind drei unterschiedliche Phasen. Eine Seite kann gecrawlt werden und dennoch nie in den Suchergebnissen erscheinen, wenn sie die Qualitätsschwellen der Suchmaschine während der Indexierung nicht erfüllt.
Googles Crawler-Dokumentation unterscheidet zwischen allgemeinen Crawlern, speziellen Crawlern und nutzerausgelösten Abrufwerkzeugen. Überprüfen Sie die dokumentierte Identität und das Verhalten des betreffenden Crawlers, wenn Sie Zugriffsprobleme untersuchen.
Auf dieser Seite
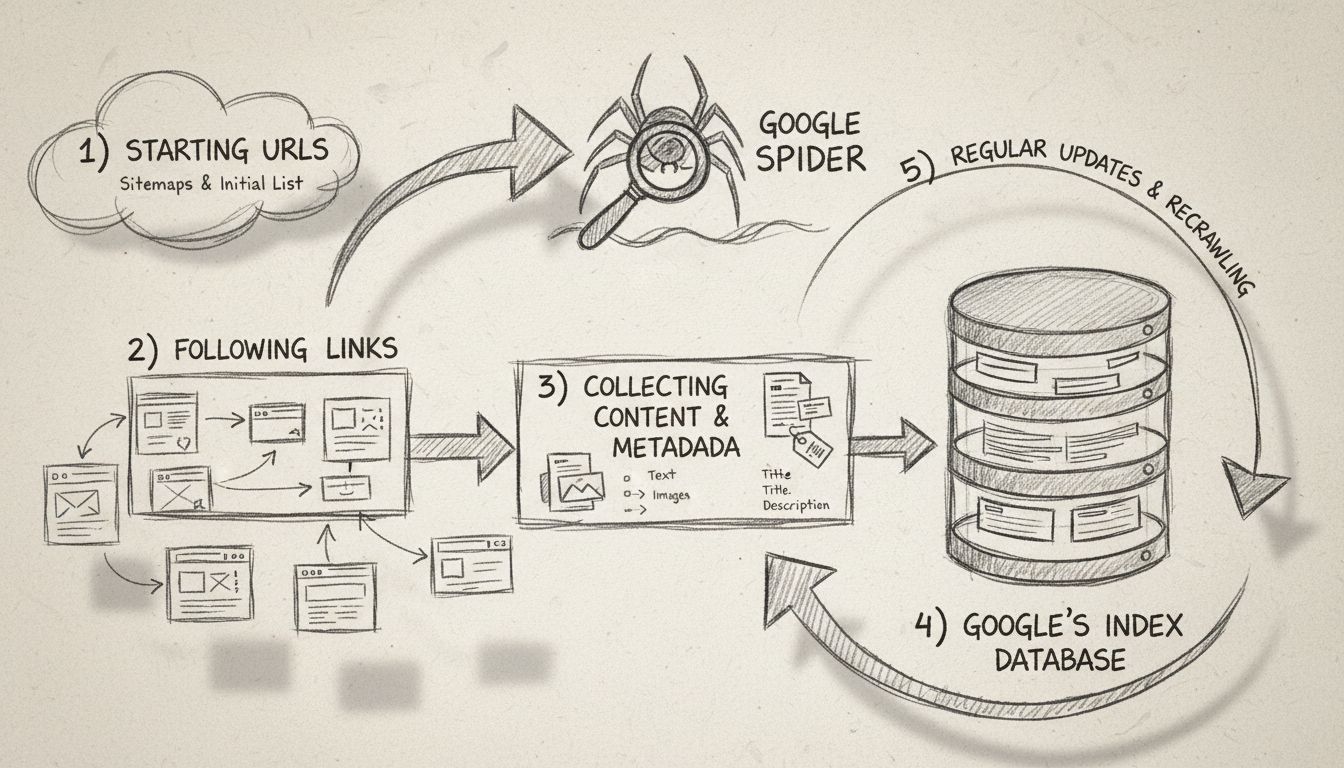
Ein Web-Crawler arbeitet in einer Endlosschleife, die auf wenigen Kernschritten basiert. Das Verständnis dieser Schritte hilft Website-Betreibern zu diagnostizieren, warum Seiten möglicherweise nicht in den Suchergebnissen erscheinen – das Problem liegt oft bereits in der Crawling-Phase, lange bevor das Ranking überhaupt eine Rolle spielt.
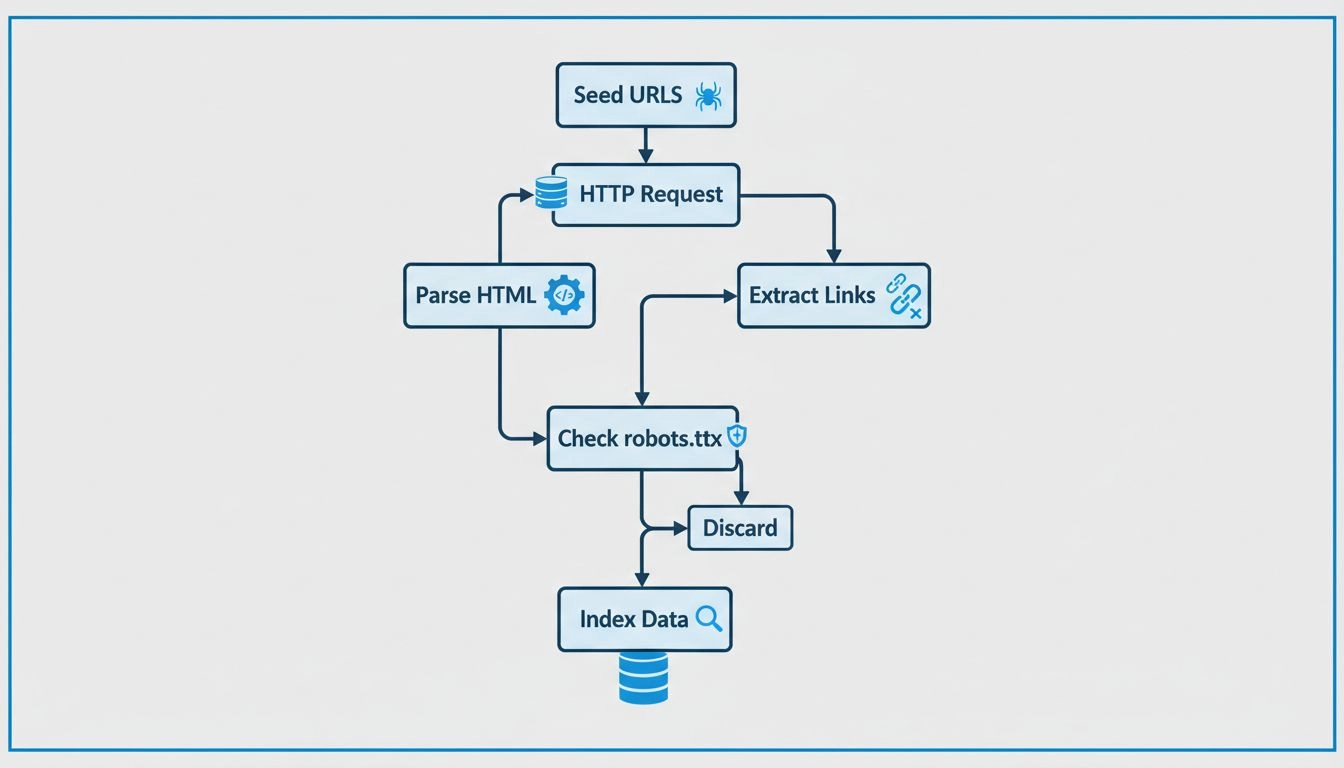
Jeder Crawler beginnt mit einem Satz bekannter URLs, den sogenannten Seed-URLs. Diese können aus zuvor gecrawlten Seiten, eingereichten Sitemaps oder manuell ausgewählten Startpunkten stammen. Der Crawler lädt jede Seed-Seite herunter, extrahiert alle darin gefundenen Hyperlinks und fügt jeden noch nicht gesehenen Link einer Warteschlange hinzu, der Crawl-Frontier.
Der Zyklus wiederholt sich dann:
Diese Schleife endet nie wirklich. Das Web verändert sich ständig, und jede Sekunde erscheinen neue Seiten. Ein Crawler arbeitet sich daher einfach durch das Nächste in der Warteschlange, besucht alte Seiten erneut, um Änderungen zu prüfen, und fügt neu entdeckte URLs hinzu.
Sobald ein Crawler eine Seite abruft, rendert er den Inhalt – liest das HTML, führt nach Möglichkeit JavaScript aus und extrahiert Text, Bilder, Metadaten und strukturierte Daten. Anschließend lädt er diese Informationen herunter und übergibt sie an den Indexer der Suchmaschine.
Nicht jeder Crawler verarbeitet JavaScript gleich gut. Googlebot rendert JavaScript und wartet auf dynamisch geladene Inhalte, aber kleinere Suchmaschinen-Crawler lesen möglicherweise nur statisches HTML. Deshalb können Websites, die vollständig mit clientseitigen JavaScript-Frameworks erstellt wurden, für manche Suchmaschinen unsichtbar sein, sofern kein serverseitiges Rendering eingerichtet ist.
Crawler entdecken neue Seiten über zwei Hauptkanäle:

Richten Sie erweitertes Tracking in wenigen Minuten ein. Keine Kreditkarte erforderlich.
Crawler behandeln nicht alle Seiten gleich. Sie arbeiten nach einem Satz von Crawl-Richtlinien, die bestimmen, welche Seiten sie besuchen, in welcher Reihenfolge und wie oft sie zurückkehren.
Ein Crawler muss entscheiden, welche URLs aus seiner Crawl-Frontier priorisiert werden. Häufige Signale sind:
Wie oft ein Crawler zu einer Seite zurückkehrt, hängt davon ab, wie häufig sich diese Seite ändert. Eine Nachrichten-Startseite wird möglicherweise alle paar Minuten gecrawlt. Eine statische „Über uns“-Seite wird vielleicht nur alle paar Monate erneut besucht. Webmaster können die Änderungshäufigkeit über XML-Sitemap-<changefreq>-Tags signalisieren, wobei Suchmaschinen diese als Hinweise und nicht als Anweisungen behandeln.
Crawler sind so programmiert, dass sie Webserver nicht überlasten. Sie respektieren eine Crawl-Ratenbegrenzung – die maximale Anzahl von Anfragen, die sie innerhalb eines bestimmten Zeitraums an eine einzelne Website senden. Wenn ein Server mit HTTP-Fehlern wie 500 oder 503 antwortet, zieht sich der Crawler zurück, um das Problem nicht zu verschlimmern. Dies ist ein Grund, warum Crawling im großen Maßstab eine echte technische Herausforderung darstellt.
Die robots.txt-Datei ist ein Textdokument, das im Stammverzeichnis einer Domain platziert wird und Crawlern mitteilt, welche URLs sie anfordern dürfen und welche nicht. Es ist das mit Abstand wichtigste Werkzeug zur Verwaltung des Crawler-Zugriffs. Ein robots.txt-Eintrag könnte wie folgt aussehen:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ überspringen, aber alles unter /public/ zulassen soll. Andere Crawler überprüfen dieselbe Datei und folgen ihren eigenen User-agent-Anweisungen. Es ist erwähnenswert, dass robots.txt ein freiwilliges Protokoll ist – gut erzogene Crawler befolgen es, aber bösartige Bots können es vollständig ignorieren.Das Crawl-Budget ist die Anzahl der Seiten, die eine Suchmaschine innerhalb eines bestimmten Zeitrahmens auf einer Website crawlt. Es wird durch zwei Faktoren bestimmt:
Für kleine Websites ist das Crawl-Budget selten ein Problem. Für große E-Commerce-Plattformen oder Content-Seiten mit Millionen von URLs wird die Verwaltung des Crawl-Budgets jedoch essenziell – verschwendete Crawls auf Duplikatinhalte, Facettennavigation-Parameter oder minderwertige Seiten bedeuten weniger Ressourcen für die Seiten, die wirklich zählen.
Jede große Suchmaschine betreibt ihren eigenen Crawler mit einem eindeutigen User-Agent-String – eine Kennung, die der Bot mit jeder HTTP-Anfrage sendet, damit Server wissen, welcher Crawler zu Besuch ist.
| Suchmaschine | Crawler-Name | User-Agent-Kennung | Zweck |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Crawlt und indexiert Webseiten für die Google-Suche und andere Google-Dienste | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Crawlt und indexiert Seiten für Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Crawlt Seiten für die Suchergebnisse von DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Crawlt Seiten für die Yandex-Suche (dominant in Russland) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Crawlt Seiten für die Baidu-Suche (dominant in China) |
| Apple | Applebot | Applebot/1.0 | Crawlt Seiten für die Spotlight-Suche und Siri-Vorschläge |
Google betreibt auch spezialisierte Crawler für verschiedene Inhaltstypen – Googlebot Image crawlt Bilder, Googlebot Video verarbeitet Videoinhalte, Googlebot News zielt auf Nachrichtenartikel ab, und AdsBot überprüft die Qualität von Landingpages für Google Ads.
Erfahren Sie als Erster von neuen Funktionen und Produkt-Updates.
Die Identifizierung, ob ein Besucher wirklich Googlebot ist, erfordert mehr als nur die Überprüfung eines User-Agent-Strings, da diese Strings gefälscht werden können. So überprüfen Sie einen Google-Crawler:
Googlebot.googlebot.com- oder google.com-Domain auflösen.Google stellt eine offizielle Dokumentation mit seinen IP-Bereichen unter google.com/bot.html zur Verfügung. Jeder Besucher, der behauptet, Googlebot zu sein, aber diese Überprüfungsschritte nicht besteht, ist ein gefälschter Bot und sollte als verdächtig behandelt werden.
Ja – jedoch mit Einschränkungen. Große Suchmaschinen betreiben spezielle Crawler für Nicht-Text-Inhalte:
VideoObject-Schema, um Titel, Beschreibung, Vorschaubild und Dauer zu erfassen.Allerdings können Crawler Bilder nicht so „sehen“ wie ein Mensch oder Videos „ansehen“. Sie verlassen sich vollständig auf Textsignale – Dateinamen, Alt-Attribute, Bildunterschriften, umgebenden Fließtext und strukturierte Daten –, um die Relevanz zu bestimmen. Inhalte hinter Login-Wänden, Paywalls oder in komplexen JavaScript-Playern werden möglicherweise überhaupt nicht gecrawlt.
Diese Begriffe werden oft synonym verwendet, beschreiben aber unterschiedliche Dinge:
| Aspekt | Web-Crawler | Web-Scraper |
|---|---|---|
| Zweck | URLs im gesamten Web entdecken und indexieren | Spezifische Daten von Zielseiten extrahieren |
| Umfang | Breit – folgt Links überallhin | Eng – zielt auf bekannte URLs oder Domains |
| Ausgabe | Speist einen Suchindex | Produziert strukturierte Daten (CSV, Datenbank, Tabellenkalkulation) |
| Typischer Betreiber | Suchmaschinen (Google, Bing) | Unternehmen, Forscher, Datenanalysten |
| Respektiert robots.txt | Ja (legitime Crawler) | Variiert – viele Scraper ignorieren es |
| Beispiele | Googlebot, Bingbot | Preisüberwachungstools, Lead-Generierungs-Scraper, KI-Trainingsdatensammler |
Suchmaschinen finden neue Seiten über mehrere Kanäle:
Der schnellste Weg, eine neue Seite crawlen zu lassen, ist die direkte Einreichung ihrer URL über die Search Console und die Sicherstellung, dass sie von einer bereits indexierten Seite derselben Website verlinkt ist.
Es gibt keinen festen Zeitplan. Die Wiederbesuchshäufigkeit hängt ab von:
Website-Betreiber können die Wiederbesuchshäufigkeit beeinflussen, indem sie regelmäßig Inhalte veröffentlichen, schnelle Server-Antwortzeiten aufrechterhalten und aktualisierte Sitemaps einreichen. Letztendlich entscheidet der Crawler jedoch selbst über seinen Zeitplan basierend auf den von ihm beobachteten Signalen.
Crawler haben im Allgemeinen keinen Zugriff auf:
Ein Crawler sieht nur, was öffentlich zugänglich und verlinkt ist. Wenn eine Seite zur Darstellung eine Authentifizierung oder Benutzerinteraktion erfordert, ist sie für Suchmaschinen praktisch unsichtbar – es sei denn, der Website-Betreiber gewährt explizit Zugriff oder bietet einen alternativen Pfad, wie z. B. eine Sitemap mit der URL in Kombination mit strukturierten Daten, die den Inhalt beschreiben.
Einen Crawler zu bauen, der für ein paar hundert Seiten funktioniert, ist unkompliziert. Einen zu bauen, der für Milliarden funktioniert, ist ein völlig anderes Problem. Häufige Fehlerpunkte sind:
Für die meisten Unternehmen ist der Betrieb eines groß angelegten Web-Crawlers ohne verwaltete Infrastruktur nicht praktikabel. Die Entscheidung läuft in der Regel darauf hinaus, ein vorhandenes Tool zu verwenden, anstatt eines von Grund auf neu zu entwickeln.
In den Vereinigten Staaten ist das Crawlen öffentlich zugänglicher Seiten im Allgemeinen legal. Mehrere Gerichtsurteile – darunter hiQ Labs v. LinkedIn – haben bestätigt, dass das Crawlen öffentlicher Daten unter bestimmten Umständen legal sein kann.
Die Legalität hängt jedoch von mehreren Faktoren ab:
Die Unterscheidung zwischen Crawling zur Suchindexierung (weithin akzeptiert) und Scraping zur kommerziellen Datenextraktion (rechtlich umstrittener) ist wichtig. Die meisten legitimen Suchmaschinen-Crawler bewegen sich in eindeutig legalem Terrain.
Nein – ChatGPT selbst ist kein Web-Crawler. ChatGPT ist ein dialogbasiertes KI-Modell, das Antworten generiert. OpenAI betreibt jedoch einen separaten Web-Crawler namens GPTBot, der öffentliche Webseiten crawlt, um Trainingsdaten für KI-Modelle zu sammeln und Live-Abruffunktionen in einigen OpenAI-Produkten zu unterstützen.
GPTBot identifiziert sich mit dem User-Agent-Token GPTBot und respektiert robots.txt-Anweisungen. Website-Betreiber, die GPTBot gezielt blockieren möchten, können ihrer robots.txt-Datei Folgendes hinzufügen:
User-agent: GPTBot
Disallow: /
Suchmaschinen-Crawler betreffen direkt alle Teilnehmer des Affiliate-Marketing-Ökosystems. Wenn eine Seite nicht gecrawlt wird, rankt sie nicht, und wenn sie nicht rankt, generiert sie keinen organischen Traffic – und keine Affiliate-Einnahmen.
Die Content-Site eines Publishers steht und fällt mit der Crawlbarkeit. Jede Produktbewertung, jeder Vergleichsleitfaden oder jede Angebotsübersicht muss von Crawlern auffindbar sein. Häufige Publisher-Fehler, die das Crawling blockieren, sind:
Publisher sollten überprüfen, ob ihre wertvollsten Seiten im Index-Coverage-Bericht der Google Search Console erscheinen und dass keine noindex-Tags oder robots.txt-Regeln sie versehentlich blockieren.
Ein Werbetreibender, der ein Affiliate-Programm betreibt, benötigt gecrawlte und indexierte Produktseiten, damit Publisher auf live sichtbare Seiten verlinken können. Wenn die Produktseiten eines Händlers nicht im Google-Index sind, haben Publisher keine Möglichkeit, Traffic dorthin zu senden. Zu den spezifischen Risiken gehören:
Händler sollten saubere URL-Strukturen pflegen, Produkt-Sitemaps einreichen und die Crawl-Statistiken in der Search Console überwachen, um Probleme zu erkennen, bevor sie Publisher-Partner betreffen.
Programm-Manager stehen zwischen Händlern und Publishern und sollten das Crawler-Verhalten verstehen, um Sichtbarkeitsprobleme zu beheben. Wenn ein Publisher meldet, dass die Produktseite eines Händlers „bei Google nicht angezeigt wird“, liegt das Problem oft beim Crawling oder der Indexierung – nicht beim Ranking. Praktische Schritte sind:
site:, ob die Seite indexiert ist.Ein Programm-Manager, der grundlegende Crawl-Probleme diagnostizieren kann, stiftet auf beiden Seiten der Affiliate-Beziehung direkten Mehrwert – indem er Händlern hilft, technische Probleme zu beheben, und Publishern bestätigt, dass die von ihnen beworbenen Seiten auffindbar sind.
Erfahren Sie, wie das Verständnis und die Optimierung für Crawler die Sichtbarkeit Ihrer Website und das Suchmaschinen-Ranking verbessern kann.
Eine Suchmaschinen-Spinne ist ein automatisierter Bot, der Webseiten durchsucht, um Inhalte für Suchmaschinen wie Google und Bing zu indexieren. Erfahren Sie, w...
Erfahren Sie, was der Google Spider (Googlebot) ist, wie er Websites crawlt und indexiert und warum er für SEO unerlässlich ist. Entdecken Sie, wie Sie Ihre Web...
Erfahren Sie, wie Webcrawler arbeiten – von Seed-URLs bis zur Indexierung. Verstehen Sie den technischen Ablauf, Crawler-Typen, robots.txt-Regeln und wie Crawle...
Treten Sie unserer Gemeinschaft zufriedener Kunden bei und bieten Sie exzellenten Kundensupport mit Post Affiliate Pro.


Cookie-Zustimmung
Wir verwenden Cookies, um Ihr Surferlebnis zu verbessern und unseren Datenverkehr zu analysieren. See our privacy policy.