

Verwendet Google LSI-Keywords? Die Wahrheit über semantisches SEO
Erfahren Sie, ob Google LSI-Keywords nutzt, und lernen Sie, wie moderne semantische Suche tatsächlich funktioniert. Verstehen Sie BERT, RankBrain und entity-bas...
11 Min. Lesezeit
Latent Semantic Indexing (LSI) ist eine mathematische Technik der natürlichen Sprachverarbeitung und Informationsrückgewinnung, die versteckte – oder latente – Beziehungen zwischen Wörtern und Dokumenten aufdeckt.
Auf dieser Seite
Latent Semantic Indexing (LSI) ist eine mathematische Technik der natürlichen Sprachverarbeitung und Informationsrückgewinnung, die versteckte – oder latente – Beziehungen zwischen Wörtern und Dokumenten aufdeckt. Anstatt exakte Keywords abzugleichen, analysiert LSI Muster des gemeinsamen Auftretens von Wörtern in einer Sammlung von Dokumenten, um abzuleiten, worum es in jedem Dokument tatsächlich geht.
Die Aufschlüsselung des Namens macht das Konzept klarer:

Richten Sie erweitertes Tracking in wenigen Minuten ein. Keine Kreditkarte erforderlich.
LSI funktioniert über eine Abfolge klar definierter mathematischer Schritte. Sie zu verstehen – selbst auf hohem Niveau – verdeutlicht, warum die Technik wichtig ist und wo ihre Grenzen liegen.
LSI beginnt mit der Konstruktion einer Term-Dokument-Matrix. Jede Zeile repräsentiert einen eindeutigen Begriff aus dem Korpus, jede Spalte ein Dokument, und jede Zelle erfasst, wie oft dieser Begriff in diesem Dokument vorkommt – oder, häufiger, einen gewichteten Wert wie TF-IDF (Termhäufigkeit–inverse Dokumenthäufigkeit).
| Dok. 1 | Dok. 2 | Dok. 3 | |
|---|---|---|---|
| Auto | 3 | 0 | 1 |
| Kraftfahrzeug | 0 | 4 | 1 |
| Motor | 2 | 3 | 0 |
| Restaurant | 0 | 0 | 5 |
Diese Matrix ist typischerweise groß und dünn besetzt – die meisten Zellen sind null, da jedes Dokument nur einen kleinen Teil des gesamten Vokabulars verwendet.
Die zentrale mathematische Operation in LSI ist die Singulärwertzerlegung. Die SVD zerlegt die Term-Dokument-Matrix in drei kleinere Matrizen:
A ≈ Uₖ Σₖ Vₖᵀ
Durch die Beibehaltung nur der oberen k Singulärwerte (und das Verwerfen der restlichen) reduziert LSI die Matrix auf eine viel kleinere, dichtere Darstellung. Dieser Schritt entfernt Rauschen, fasst verwandte Begriffe zusammen und legt die latente semantische Struktur frei. Die Wahl von k ist entscheidend: Zu klein und Sie verlieren bedeutungsvolle Unterscheidungen; zu groß und Sie behalten Rauschen. In der Praxis liegt k für mittelgroße Sammlungen oft zwischen 100 und 300.
Sobald Dokumente und Begriffe in den reduzierten semantischen Raum abgebildet sind, wird ihr Vergleich unkompliziert. Eine Abfrage wird in denselben Raum projiziert, und ihr Vektor wird mit jedem Dokumentvektor mittels Kosinus-Ähnlichkeit verglichen – einem Maß, das den Winkel zwischen zwei Vektoren erfasst, wobei Werte nahe 1 auf eine größere Ähnlichkeit hindeuten.
Die Begriffe Latent Semantic Indexing (LSI) und Latent Semantic Analysis (LSA) werden oft synonym verwendet, und das aus gutem Grund: Sie beschreiben dasselbe zugrundeliegende mathematische Verfahren. Der Unterschied liegt in der Anwendung, nicht in der Technik.
Kurz gesagt: LSA ist die Analysetechnik; LSI ist ihre Anwendung auf Suche und Retrieval. Das ursprüngliche Paper von Deerwester et al. (1990) verwendete den Begriff „Latent Semantic Indexing“, weshalb die Information-Retrieval-Community LSI übernahm, während die breitere NLP- und Kognitionswissenschafts-Community tendenziell LSA bevorzugt.
Erfahren Sie als Erster von neuen Funktionen und Produkt-Updates.
LSI wurde in einer Reihe realer Systeme eingesetzt, insbesondere vor dem Aufkommen neuronaler Netzwerkansätze.
LSI war eine der frühesten Techniken, die semantische Suche ermöglichte – das Abrufen von Dokumenten basierend auf konzeptioneller Relevanz anstatt auf Keyword-Überschneidungen. Frühe Unternehmenssuchsysteme, digitale Bibliothekskataloge und akademische Forschungsdatenbanken nutzten LSI zur Verbesserung des Recalls: des Anteils tatsächlich abgerufener relevanter Dokumente.
Da LSI Dokumente in einen gemeinsamen semantischen Raum abbildet, unterstützt es auf natürliche Weise das Clustering. Dokumente zu ähnlichen Themen landen im reduzierten Raum nahe beieinander, selbst wenn sie keine exakte Vokabularüberschneidung aufweisen. Dies machte LSI nützlich für die automatische Themenkategorisierung, die Prüfung juristischer Dokumente und die Patentsuche.
Eine der am häufigsten zitierten Anwendungen von LSA außerhalb der Suche ist der Intelligent Essay Assessor, der Ende der 1990er Jahre entwickelt wurde. Das System nutzte LSA, um Schüleraufsätze mit einem Korpus von Experten verfasster Texte zu vergleichen und Bewertungen zu erzeugen, die gut mit menschlichen Bewertern korrelierten. Diese Anwendung zeigte, dass LSA etwas Sinnvolles über textuelle Inhalte erfassen konnte, ohne sprachliche Regeln oder domänenspezifisches Wissen.
Die ursprüngliche LSA-Forschung wurde teilweise durch Fragen der kognitiven Psychologie motiviert. Landauer und Dumais zeigten, dass LSA Aspekte des menschlichen Vokabularerwerbs und semantischer Priming-Effekte reproduzieren konnte, was darauf hindeutet, dass allein die statistische Struktur des Sprachkontakts signifikante Teile davon erklären kann, wie Menschen Wortbedeutungen lernen.
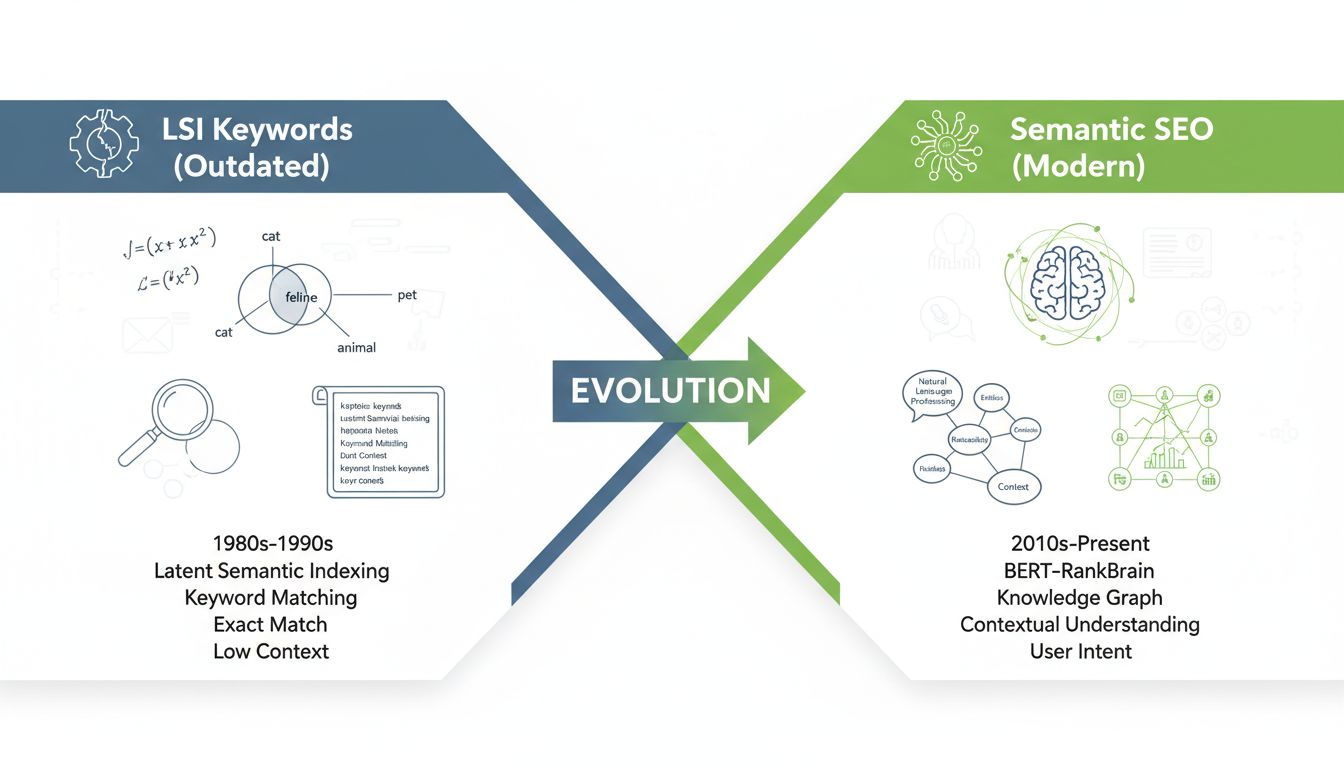
Nein. Google verwendet Latent Semantic Indexing nicht in seinen Ranking-Algorithmen. Dies ist keine Spekulation – Google-Vertreter haben dies direkt erklärt.
Die Verwirrung hat eine historische Wurzel. In den frühen 2000er Jahren, als Googles Algorithmus immer ausgefeilter wurde, begannen SEO-Praktiker nach einem Rahmenwerk zu suchen, um das zu erklären, was sie beobachteten. LSI – eine echte, veröffentlichte Technik zum semantischen Verständnis – bot eine praktische Bezeichnung. Die Idee, dass Google so etwas wie LSI verwenden könnte, um Keyword-Stuffing zu „durchschauen“ und Seitenthemen zu verstehen, war plausibel genug, um hängenzubleiben.
Aber Googles moderner Ansatz zum Verständnis von Inhalten ist weitaus fortschrittlicher. Systeme wie RankBrain (eingeführt 2015), Neural Matching und BERT (2019) verwenden Deep Learning und transformerbasierte Architekturen zur Sprachmodellierung. Diese Systeme verarbeiten Wortstellung, Kontextfenster, Entitätsbeziehungen und Benutzerinteraktionssignale – nichts davon wird von LSI abgedeckt. LSI ist eine lineare Algebra-Technik, die auf einer statischen Bag-of-Words-Repräsentation arbeitet; Googles Infrastruktur ist um Größenordnungen komplexer.
Mitte der 2000er Jahre begannen SEO-Tools und Blogs, die Idee zu verbreiten, dass Google LSI verwende, um verwandte Begriffe zu identifizieren und Seiten zu bestrafen, denen semantische Tiefe fehlte. Das Konzept war attraktiv: Es gab SEOs eine wissenschaftlich klingende Begründung für das Schreiben umfangreicherer Inhalte und eine Checklisten-artige Taktik (finden Sie Ihre LSI-Keywords, streuen Sie sie ein, ranken Sie höher). Es entstanden Tools, die vorgaben, LSI-Keywords für jedes beliebige Thema zu generieren.
Das Problem ist, dass diese Erzählung zwei verschiedene Dinge vermischt: die mathematische Technik namens LSI und die allgemeine Praxis, verwandte Begriffe in Inhalten zu verwenden.
Der zugrundeliegende Ratschlag – umfassende, thematisch reichhaltige Inhalte zu schreiben – bleibt richtig. Die Bezeichnung ist irreführend.
Im strengen technischen Sinne: nein. Es gibt keinen Algorithmus innerhalb von Google, der eine Abfrage nimmt, eine SVD auf einer Term-Dokument-Matrix ausführt und eine Liste von „LSI-Keywords“ zurückgibt, die Sie auf Ihrer Seite einfügen sollten.
Was es tatsächlich gibt, ist das beobachtbare Phänomen, dass Seiten, die für eine bestimmte Abfrage gut ranken, tendenziell ein breiteres Vokabular verwandter Begriffe verwenden. Dies ist eine Korrelation, kein Beleg für einen LSI-basierten Mechanismus. Moderne Suchmaschinen verwenden neuronale Sprachmodelle, die auf riesigen Korpora trainiert wurden, um zu verstehen, dass „Kraftstoffeffizienz“, „MPG“ und „Hybridmotor“ alle für eine Seite über Autos relevant sind – ohne jemals eine Term-Dokument-Matrix zu erstellen oder einen einzigen Singulärwert zu berechnen.
Wenn Sie ein Suchsystem, eine Content-Empfehlungsmaschine oder eine Anwendung entwickeln, die semantische Ähnlichkeit zwischen Texten verstehen muss, ist die Antwort klar: Verwenden Sie Embeddings.
LSI hat einige wenige Nischenvorteile. Es ist transparent – Sie können die Term- und Dokumentvektoren einsehen und verstehen, welche Dimensionen zur Ähnlichkeit beitragen. Es erfordert keine Trainingsdaten über die Dokumentsammlung selbst hinaus. Es läuft auf bescheidener Hardware und kann mit wenigen Dutzend Zeilen Python mit scikit-learns TruncatedSVD implementiert werden. Für eine kleine, statische Dokumentsammlung – sagen wir, ein paar tausend Produktbeschreibungen auf einer Affiliate-Seite – kann LSI mit minimaler Komplexität akzeptable Ergebnisse liefern.
Moderne Embedding-Modelle – ob Sentence-Transformer wie all-MiniLM-L6-v2, proprietäre APIs von OpenAI oder Cohere oder Open-Weight-Modelle – erfassen weitaus reichhaltigere semantische Beziehungen, als LSI jemals konnte. Sie verstehen Wortstellung, Verneinung, Entitätsbeziehungen und crosslinguale Semantik. Sie behandeln Polysemie kontextuell: „Bank“ als Finanzinstitut und „Bank“ als Flussufer erhalten je nach umgebenden Wörtern unterschiedliche Vektorrepräsentationen.
| Kriterium | LSI | Moderne Embeddings |
|---|---|---|
| Behandelt Synonymie | Ja, teilweise | Ja, effektiv |
| Behandelt Polysemie | Nein (ein Vektor pro Begriff) | Ja (kontextuell) |
| Erfasst Wortstellung | Nein (Bag of Words) | Ja |
| Benötigte Trainingsdaten | Keine über Zielkorpus hinaus | Vortrainiert auf großen Korpora |
| Rechenaufwand | Niedrig | Mittel bis hoch |
| Interpretierbarkeit | Hoch (einsehbare Dimensionen) | Niedrig (Black-Box-Vektoren) |
| Am besten geeignet für | Kleine, statische Sammlungen | Produktionssuche, RAG, Empfehlungen |
Für jedes Projekt, das wachsen, echten Benutzern dienen oder nuancierte Abfragen verstehen muss, sind Embeddings die richtige Wahl.
Obwohl es für die großflächige Suche überholt ist, bleibt LSI in mehreren spezifischen Kontexten relevant.
LSI ist ein hervorragendes Lehrmittel. Seine Mechanik – das Erstellen einer Matrix, deren Zerlegung und das Messen der Ähnlichkeit im reduzierten Raum – macht die abstrakte Idee der „semantischen Ähnlichkeit“ konkret. Studierende, die LSI von Grund auf implementieren, erlangen ein echtes Verständnis von Vektorraummodellen, das sich direkt auf die Arbeit mit modernen Embeddings übertragen lässt.
Für eine Sammlung von einigen tausend Dokumenten – interne Wikis, Produktkataloge, juristische Verträge – kann LSI schnell ohne GPU, ohne API-Kosten und ohne Modell-Serving-Infrastruktur bereitgestellt werden. Die Ergebnisse sind nicht state-of-the-art, aber für interne Tools und Prototypen oft gut genug.
Forscher und Ingenieure verwenden LSI immer noch als Basislinie bei der Evaluierung neuer Retrieval- oder Themenmodellierungstechniken. Wenn Ihr ausgefallenes neuronales Modell eine 30 Jahre alte lineare Algebra-Methode kaum übertrifft, haben Sie ein Problem. LSI setzt eine nützliche Untergrenze.
Einige Unternehmenssuch- und Dokumentenmanagementsysteme haben LSI vor Jahren eingeführt und haben keinen zwingenden Grund zur Migration. Wenn die Sammlung stabil ist, die Abfragemuster gut verstanden sind und die Benutzer zufrieden sind, könnte die Ersetzung von LSI durch Embeddings eine Lösung auf der Suche nach einem Problem sein.
Wenn LSI kein Google-Ranking-Faktor ist und „LSI-Keywords“ nicht existieren, was sollte ein Affiliate-Vermarkter oder Programm-Manager dann tatsächlich tun? Die Antwort ist einfacher – und effektiver – als die Jagd nach einer magischen Keyword-Liste.
Die wahre Erkenntnis hinter dem LSI-Keyword-Konzept ist, dass Seiten, die ein Thema gründlich abdecken, tendenziell besser ranken. Dafür ist keine SVD erforderlich. Es erfordert zu verstehen, welche Fragen Ihr Publikum hat, und diese zu beantworten. Für eine Affiliate-Seite, die Fitness-Tracker bewertet, bedeutet dies, Akkulaufzeit, Wasserdichtigkeitsklassen, Herzfrequenzgenauigkeit, Qualität der Begleit-App und Preisvergleiche abzudecken – nicht weil ein Algorithmus diese Begriffe verlangt, sondern weil die Leser es tun.
Keyword-Recherche-Tools sind wertvoll, um verwandte Suchanfragen zu entdecken, das Suchvolumen zu verstehen und Konkurrenzinhalte zu analysieren. Nutzen Sie sie dafür. Verwenden Sie sie nicht, weil sie vorgeben, „LSI-Keywords“ zu generieren. Googles Autocomplete, „Leute fragen auch“-Boxen und „Ähnliche Suchanfragen“ am Ende der SERP sind kostenlos und spiegeln direkt echte Benutzeranfragen wider – sie sind nützlicher als jedes Drittanbieter-LSI-Tool.
Googles moderner Ansatz zum Inhaltsverständnis dreht sich um Entitäten – reale Dinge, Personen, Orte und Konzepte – und deren Beziehungen. Wenn Sie über ein Produkt schreiben, nennen Sie die Marke, die Kategorie, den Anwendungsfall, die Alternativen und die relevanten Spezifikationen. Dies sind Entitäten. Sie auf natürliche Weise abzudecken, signalisiert thematische Tiefe auf eine Weise, die ein maschinelles Lernsystem erkennen kann, ohne dass eine veraltete Matrixzerlegungstechnik erforderlich ist.
LSI hat gut dokumentierte Einschränkungen, die erklären, warum es weitgehend überholt wurde.
LSI behandelt jedes Dokument als eine ungeordnete Sammlung von Wörtern. Wortstellung, Syntax und grammatikalische Struktur werden vollständig ignoriert. „Der Hund biss den Mann“ und „der Mann biss den Hund“ erzeugen identische Repräsentationen. Für viele reale Abfragen ist dies relevant.
In LSI erhält jeder Begriff genau einen Vektor – unabhängig vom Kontext. Das Wort „Schläger“ (Tier vs. Sportgerät) hat in jedem Dokument dieselbe Repräsentation. Moderne kontextuelle Embeddings lösen dies, indem sie für dasselbe Wort in verschiedenen Kontexten unterschiedliche Vektoren erzeugen.
LSI erstellt seinen semantischen Raum aus einer festen Dokumentsammlung. Das Hinzufügen neuer Dokumente erfordert eine Neuberechnung der SVD – oder zumindest die Projektion neuer Dokumente in den bestehenden Raum, was neues Vokabular möglicherweise nicht gut erfasst. Dies macht LSI ungeeignet für dynamische Sammlungen wie Nachrichtenfeeds oder ständig aktualisierte Produktkataloge.
Die SVD ist bei großen Matrizen rechenintensiv. Eine Term-Dokument-Matrix für eine Sammlung in Web-Größenordnung wäre nicht handhabbar. Die Technik wurde für Sammlungen von Tausenden bis Zehntausenden von Dokumenten entwickelt – Größenordnungen kleiner, als was moderne Suchmaschinen verarbeiten.
LSI kann nicht zwischen „gut“ und „nicht gut“ unterscheiden – beide enthalten „gut“ in ähnlicher Nähe zu anderen Begriffen. Stimmung, Sarkasmus und feinkörnige Bedeutungsunterschiede liegen außerhalb seiner Reichweite.
Der Begriff „LSI-Keywords“ wird in SEO-Ratschlägen oft locker verwendet. Ein verwandtes Wort ist kein Beweis dafür, dass eine Suchmaschine Latent Semantic Indexing verwendet. Decken Sie bei einem Affiliate-Vergleich oder Produktratgeber die tatsächlichen Fragen des Käufers ab und erklären Sie relevante Konzepte auf natürliche Weise; fügen Sie keine Liste angeblicher LSI-Begriffe hinzu, um Rankings zu verbessern.
Entdecken Sie, wie Sie mit LSI und semantischen Keywords die Suchrelevanz Ihrer Inhalte steigern und mehr organischen Traffic erzielen können. Erkunden Sie die Lösungen von Post Affiliate Pro für Affiliate-Vermarkter.
Erfahren Sie, ob Google LSI-Keywords nutzt, und lernen Sie, wie moderne semantische Suche tatsächlich funktioniert. Verstehen Sie BERT, RankBrain und entity-bas...
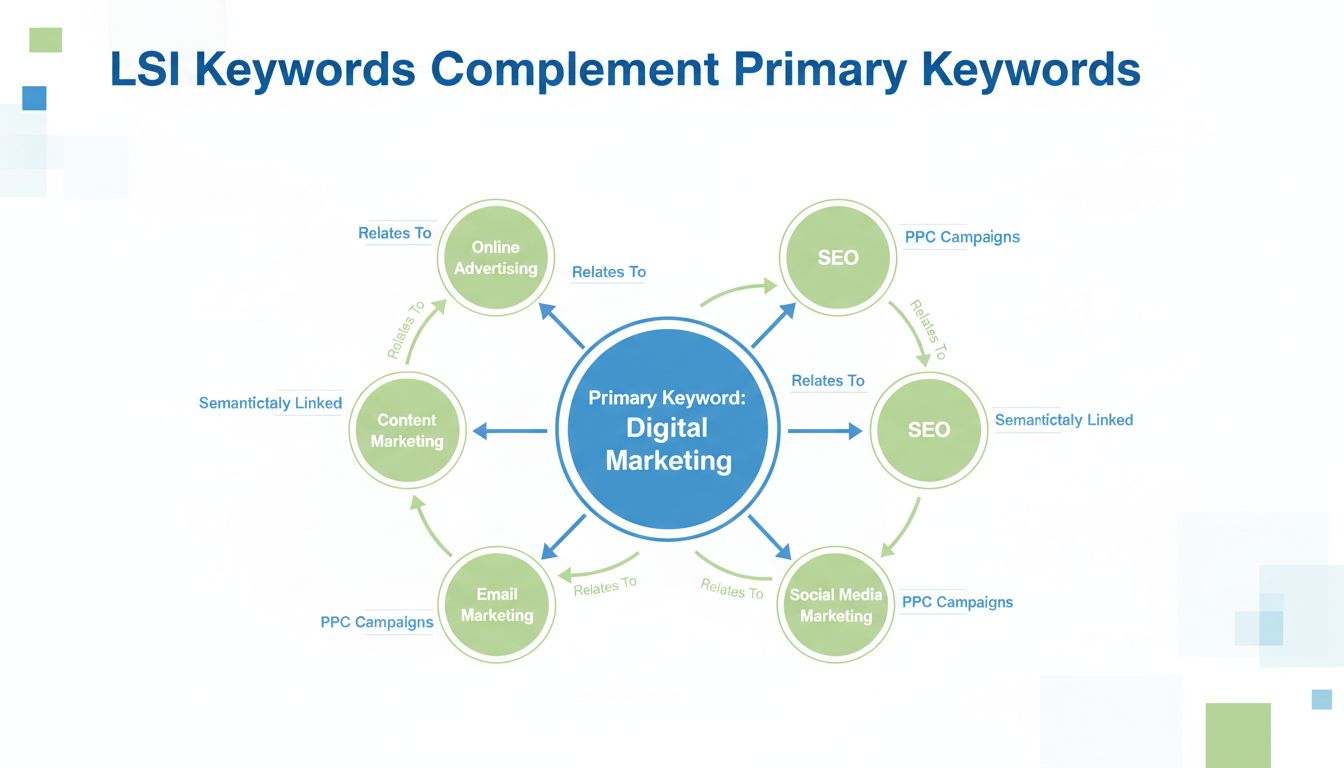
Erfahren Sie, warum LSI-Keywords Ihre Haupt-Keywords ergänzen und nicht ersetzen sollten. Entdecken Sie, wie semantische Keywords die Relevanz von Inhalten stei...
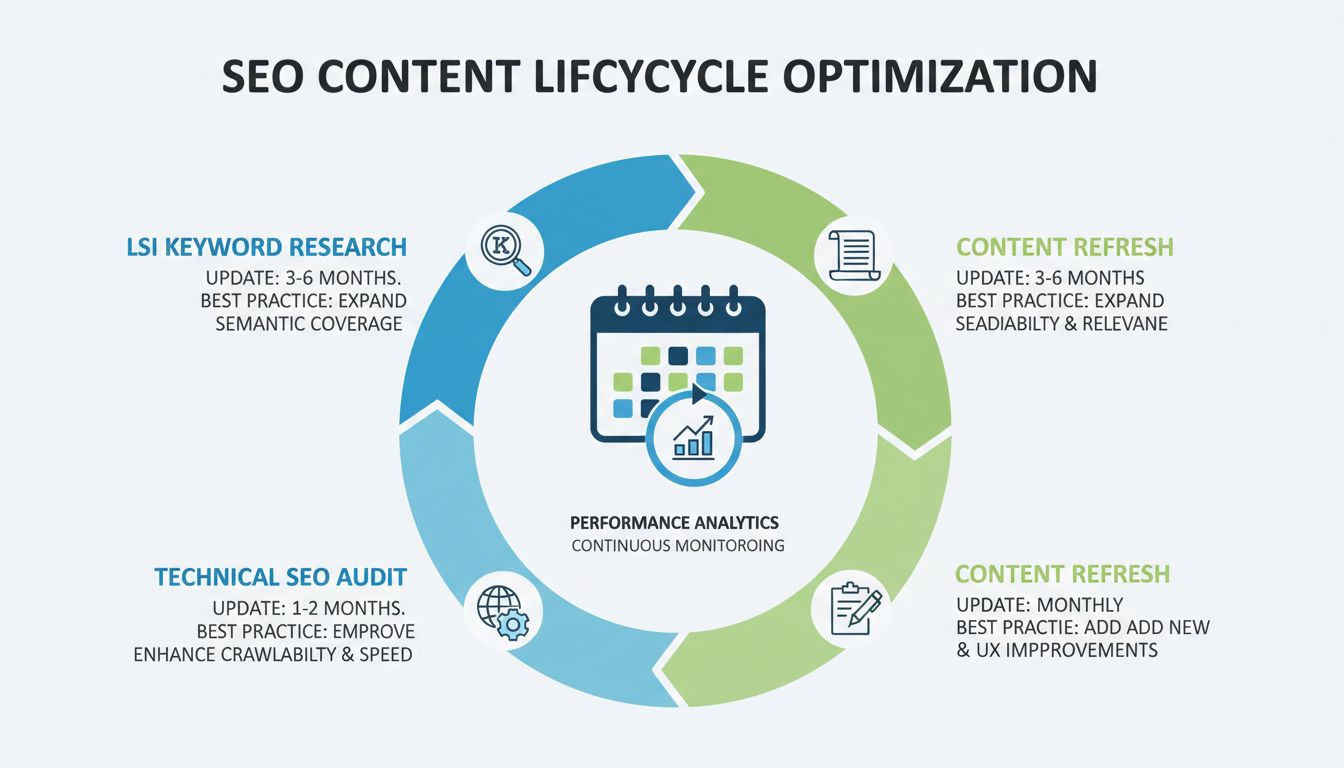
Erfahren Sie, wie oft Sie Inhalte mit LSI-Keywords aktualisieren sollten. Entdecken Sie Best Practices für Keyword-Recherche, Onpage-Optimierung und Zeitpläne f...
Treten Sie unserer Gemeinschaft zufriedener Kunden bei und bieten Sie exzellenten Kundensupport mit Post Affiliate Pro.
Cookie-Zustimmung
Wir verwenden Cookies, um Ihr Surferlebnis zu verbessern und unseren Datenverkehr zu analysieren. See our privacy policy.