Was ist statistische Signifikanz?
Die Kern-Definition
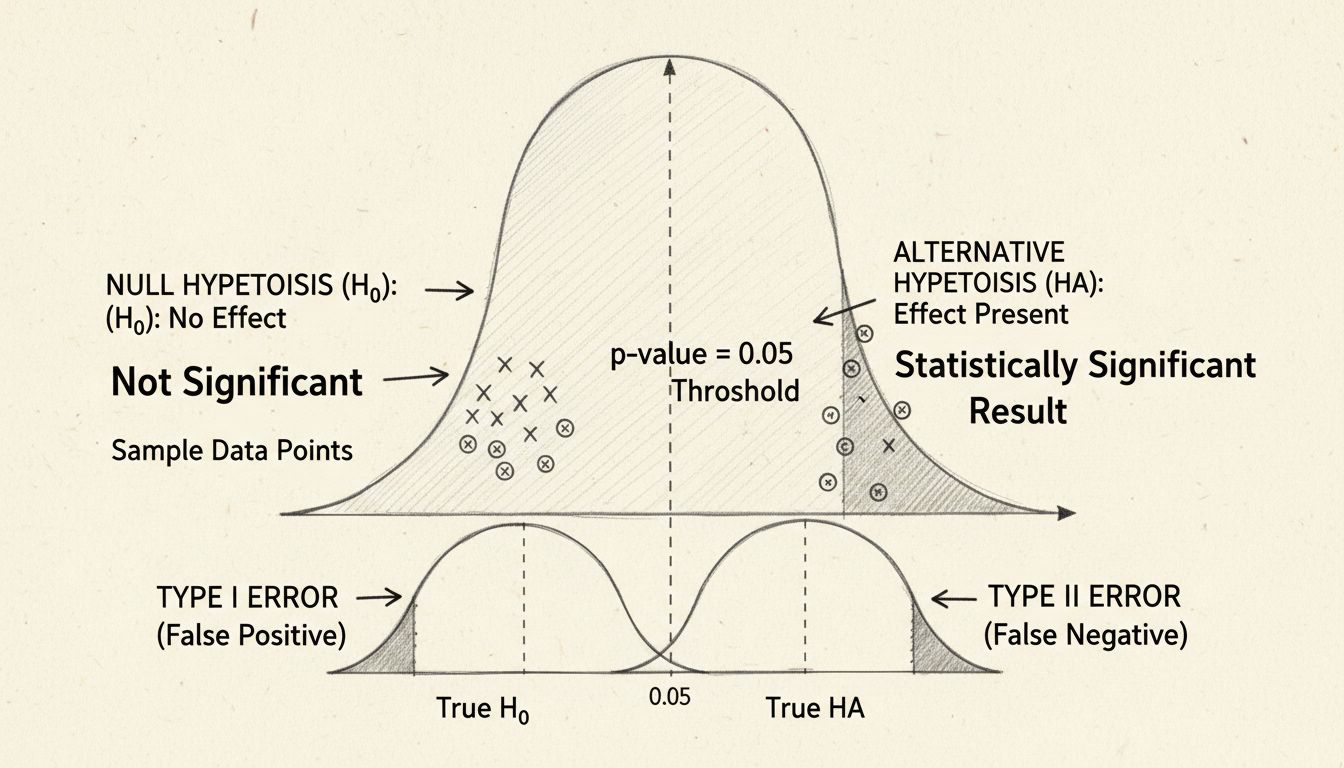
Statistische Signifikanz ist die Wahrscheinlichkeit, dass eine Beziehung zwischen zwei oder mehr Variablen durch etwas anderes als Zufall verursacht wird. Formal ausgedrückt ist es die Wahrscheinlichkeit, dass ein beobachteter Unterschied – oder ein extremerer – eintreten würde, wenn die Nullhypothese (die Annahme, dass kein echter Effekt vorliegt) wahr wäre.
Statistische Signifikanz vs. Zufall
Jeder Datensatz enthält Zufallsvariation – die natürlichen Schwankungen, die selbst dann auftreten, wenn kein zugrunde liegender Effekt existiert. Wenn Sie eine faire Münze 100 Mal werfen, werden Sie selten genau 50 Mal Kopf erhalten. Diese Abweichung ist zufälliges Rauschen, kein Beleg dafür, dass die Münze manipuliert ist.
Statistische Signifikanz quantifiziert, ob die Abweichung, die Sie sehen, im Verhältnis zu Ihrer Stichprobengröße groß genug ist, um allein durch zufälliges Rauschen unwahrscheinlich zu sein. Ist dies der Fall, können Sie die Nullhypothese verwerfen und daraus schließen, dass wahrscheinlich ein echter Effekt vorliegt.
Zwei verwandte Konzepte helfen hier:
- Zufall: Die Wahrscheinlichkeit, dass ein beobachteter Unterschied allein aus Stichprobenschwankungen resultiert.
- Zufallsvariation (oder zufälliges Rauschen): Die inhärente Unvorhersagbarkeit in jedem Messprozess. Größere Stichproben verringern ihren Einfluss und machen echte Effekte leichter erkennbar.
Ein einfaches Beispiel aus der Praxis
Angenommen, Sie betreiben einen Online-Shop und testen zwei Versionen einer Produktseite. Version A konvertiert bei 4,2 %. Version B konvertiert bei 4,8 %. Das ist ein Unterschied von 0,6 Prozentpunkten – aber ist er real?
Sie führen einen statistischen Test durch. Er liefert einen p-Wert von 0,03.
Wenn der p-Wert hingegen 0,30 betrüge, wäre die gleiche Lücke vollständig mit Zufall vereinbar – und darauf zu reagieren wäre verfrüht.
Starten Sie noch heute Ihr Affiliate-Programm
Richten Sie erweitertes Tracking in wenigen Minuten ein. Keine Kreditkarte erforderlich.
Wie statistische Signifikanz funktioniert
Die Nullhypothese und die Alternativhypothese
Jeder Signifikanztest beginnt mit zwei konkurrierenden Aussagen:
- Nullhypothese (H₀): Es gibt keinen echten Unterschied oder Zusammenhang. Jeder beobachtete Unterschied beruht auf Zufallsvariation.
- Alternativhypothese (H₁): Es gibt einen echten Unterschied oder Zusammenhang.
Der Test beweist H₁ nicht direkt.
Dieses Rahmenwerk findet direkt Anwendung bei A/B-Tests.
P-Werte verstehen
Häufige Fehlinterpretationen, die Sie vermeiden sollten:
- p = 0,03 bedeutet NICHT, dass die Nullhypothese mit 3 % Wahrscheinlichkeit wahr ist. Es beschreibt die Wahrscheinlichkeit der Daten unter der Nullhypothese, nicht die Wahrscheinlichkeit der Nullhypothese angesichts der Daten.
- p = 0,03 bedeutet NICHT, dass der Effekt zu 97 % wahrscheinlich real ist. Der p-Wert sagt nichts über die Wahrscheinlichkeit aus, dass die Alternativhypothese korrekt ist.
- Ein p-Wert über 0,05 beweist NICHT die Nullhypothese. Es bedeutet lediglich, dass die Daten nicht überraschend genug sind, um sie zu verwerfen – eine völlig andere Aussage.
Signifikanzniveaus (Alpha)
Das Signifikanzniveau, bezeichnet als α (Alpha), ist der Schwellenwert, den Sie vor der Durchführung eines Tests festlegen. Es repräsentiert Ihre Toleranz für Falsch-Positive – das Verwerfen der Nullhypothese, obwohl sie tatsächlich wahr ist. Dies wird auch als Fehler 1. Art bezeichnet.
| Schwellenwert | Bedeutung | Risiko eines Falsch-Positivs |
|---|
| α = 0,05 | Standard in den meisten Bereichen | 5 % (1 von 20) |
| α = 0,01 | Strenger; verwendet, wenn Falsch-Positive kostspielig sind | 1 % (1 von 100) |
| α = 0,001 | Sehr streng; Entscheidungen mit hohem Risiko | 0,1 % (1 von 1.000) |
Wenn p < α, ist das Ergebnis auf diesem Niveau statistisch signifikant.
Konfidenzintervalle erklärt
Ein Konfidenzintervall liefert eine Spanne plausibler Werte für die wahre Effektstärke. Ein 95-%-Konfidenzintervall bedeutet: Wenn Sie die Studie 100 Mal wiederholen würden, würden etwa 95 dieser Intervalle den wahren Wert enthalten.
Engere Intervalle deuten auf präzisere Schätzungen hin – typischerweise das Ergebnis größerer Stichproben. Im Geschäftskontext sind Konfidenzintervalle oft aussagekräftiger als p-Werte allein, da sie die Größe und Richtung eines Effekts zeigen und nicht nur, ob er existiert.
Ist 0,05 statistisch signifikant? (und andere Schwellenwerte)
Die 0,05-Konvention
Ja – in den meisten angewandten Bereichen ist p < 0,05 der Standard, um statistische Signifikanz zu beanspruchen. Diese Konvention geht auf Ronald Fishers Arbeiten in den 1920er Jahren zurück und hat sich, wenngleich etwas willkürlich, gehalten, weil sie zwei Risiken ausgleicht: Falsch-Positive (Fehler 1. Art) und Falsch-Negative (Fehler 2. Art, bei denen ein echter Effekt übersehen wird).
0,01 vs. 0,05: Was ist signifikanter?
Ein p-Wert von 0,01 ist statistisch signifikanter als 0,05, da er auf eine geringere Wahrscheinlichkeit hinweist, dass das beobachtete Ergebnis auf Zufall beruht. Bei α = 0,01 akzeptieren Sie nur ein 1-%-Risiko eines Falsch-Positivs, verglichen mit 5 % bei α = 0,05.
Ein niedrigerer p-Wert bedeutet jedoch nicht automatisch einen größeren oder wichtigeren Effekt. Bei einer riesigen Stichprobe kann selbst ein trivial kleiner Unterschied p < 0,001 erzeugen. Deshalb müssen die Effektstärke und die praktische Signifikanz neben dem p-Wert bewertet werden.
Wenn p < 0,001
Ein p-Wert unter 0,001 bedeutet, dass das beobachtete Ergebnis bei Wahrheit der Nullhypothese seltener als 1 von 1.000 Mal durch Zufall auftreten würde. Dies ist ein starker Beleg gegen die Nullhypothese – garantiert aber dennoch keine praktische Bedeutung.
Newsletter abonnieren
Erfahren Sie als Erster von neuen Funktionen und Produkt-Updates.
Faktoren, die die statistische Signifikanz beeinflussen
Stichprobengröße
Die Stichprobengröße ist der einflussreichste Faktor. Größere Stichproben verringern die Auswirkungen von Zufallsvariationen und erleichtern das Erkennen echter Unterschiede. Deshalb kann eine Steigerung der Konversionsrate um 2 % bei 50.000 Besuchern signifikant sein, bei 500 Besuchern jedoch nicht.
Für Websites mit wenig Traffic bedeutet dies, dass Tests länger laufen oder auf größere Effekte abzielen müssen.
Effektstärke
Die Effektstärke misst die Größe des beobachteten Unterschieds – nicht nur, ob er existiert. Eine große Effektstärke (z. B. eine Steigerung der Konversionsrate um 30 %) erreicht die Signifikanz schneller und mit kleineren Stichproben. Eine winzige Effektstärke (z. B. 0,5 %) erfordert enorme Stichproben, um zuverlässig erkannt zu werden.
Hier wird die Beziehung zwischen statistischer Signifikanz und praktischer Signifikanz entscheidend. Ein Ergebnis kann statistisch signifikant, aber praktisch irrelevant sein, wenn der Effekt für Geschäftsentscheidungen zu klein ist.
Datenqualität
Kein statistischer Test kann schlechte Daten ausgleichen. Häufige Datenqualitätsprobleme sind:
- Selektionsverzerrung: Die Stichprobe repräsentiert nicht die Zielpopulation.
- Messfehler: Die verfolgte Kennzahl ist unzuverlässig oder inkonsistent.
- Störvariablen: Ein nicht gemessener Faktor treibt den beobachteten Unterschied an.
Bevor Sie die statistische Signifikanz berechnen, vergewissern Sie sich, dass Ihre Datenerfassung sauber, konsistent und frei von systematischen Verzerrungen ist. Ein signifikantes Ergebnis aus fehlerhaften Daten ist schlimmer als gar kein Ergebnis.
Statistische Teststärke (Power)
Die statistische Teststärke ist die Wahrscheinlichkeit, dass ein Test einen echten Effekt erkennt, wenn dieser existiert. Sie ist das Komplement der Fehler-2.-Art-Rate (β).
Die Teststärke hängt von der Stichprobengröße, der Effektstärke und dem gewählten Signifikanzniveau ab. Zu schwache Tests (Unterpowering) sind ein häufiger Grund, warum scheinbar vielversprechende A/B-Testergebnisse nicht reproduziert werden können.
So berechnen Sie statistische Signifikanz
Gängige statistische Tests
Unterschiedliche Datentypen erfordern unterschiedliche Tests:
| Test | Anwendungsfall | Beispiel |
|---|
| t-Test | Vergleich der Mittelwerte zweier Gruppen | Konversionsraten: Version A vs. Version B |
| Chi-Quadrat-Test | Vergleich kategorialer Häufigkeiten | Klickraten über mehrere Anzeigenmotive hinweg |
| z-Test | Vergleich von Anteilen bei großen Stichproben | Konversionsanteile von Landingpages |
| ANOVA | Vergleich der Mittelwerte von drei oder mehr Gruppen | Leistung über mehrere Affiliate-Partner hinweg |
Sie müssen statistische Signifikanz nicht von Hand berechnen. Weit verbreitete Werkzeuge sind:
- A/B-Testplattformen (Optimizely, VWO, Google Optimize) – integrierte Signifikanzberechnungen
- Eigenständige Rechner (Evan Millers Tools, AB Testguide) – kostenlos, webbasiert
- Statistiksoftware (R, Python SciPy, SPSS) – für individuelle Analysen
Die meisten Tools geben sowohl den p-Wert als auch das Konfidenzintervall aus. Überprüfen Sie immer beide, bevor Sie eine Entscheidung treffen.
Schritt-für-Schritt-Workflow für A/B-Tests
- Definieren Sie Ihre Metrik: Wählen Sie eine einzelne primäre Metrik (Konversionsrate, Klickrate, Umsatz pro Besucher).
- Berechnen Sie die erforderliche Stichprobengröße: Nutzen Sie einen Stichprobenrechner basierend auf Ihrer Ausgangskonversionsrate und dem minimal erkennbaren Effekt.
- Randomisieren und Test durchführen: Teilen Sie den Traffic gleichmäßig zwischen Kontroll- und Behandlungsgruppe auf. Brechen Sie den Test nicht vorzeitig ab.
- Ergebnisse analysieren: Vergleichen Sie den p-Wert mit α. Prüfen Sie das Konfidenzintervall für die Effektstärke.
- Entscheiden: Wenn das Ergebnis signifikant und praktisch bedeutsam ist, setzen Sie die Gewinnervariante um. Wenn nicht, dokumentieren Sie das Ergebnis und testen Sie etwas anderes.
Statistische Signifikanz im Affiliate-Marketing
Statistische Signifikanz ist nicht nur ein akademisches Konzept. Im Affiliate-Marketing, wo Provisionen, Budgets und Partnerbeziehungen von Leistungsdaten abhängen, ist sie eine praktische Absicherung gegen kostspielige Fehlentscheidungen.
Für Werbetreibende
Werbetreibende, die Affiliate-Programme betreiben, testen routinemäßig Landingpages, Angebotsstrukturen und Werbemittel. Statistische Signifikanz stellt sicher, dass Entscheidungen darüber, welche Version skaliert wird, auf echten Leistungsunterschieden basieren und nicht auf zufälligen Schwankungen.
Beispiel-Workflow: Ein Werbetreibender testet zwei Provisionsstrukturen – einen festen Satz von 10 % gegenüber einem gestaffelten Modell mit 5 %/12 %/18 %. Nach 30 Tagen und 5.000 Transaktionen zeigt das gestaffelte Modell einen um 22 % höheren durchschnittlichen Bestellwert. Ein t-Test ergibt p = 0,02. Der Werbetreibende kann die gestaffelte Struktur zuversichtlich ausrollen, da er weiß, dass der beobachtete Unterschied wahrscheinlich kein zufälliges Rauschen ist.
Ohne Signifikanztest hätte der Werbetreibende die Änderung möglicherweise aufgrund einer kurzfristigen Schwankung vorgenommen – und möglicherweise die Partnereinnahmen verringert, wenn sich der Effekt umgekehrt hätte.
Für Publisher
Publisher (Affiliates) treffen Entscheidungen darüber, welche Produkte sie bewerben, in welche Traffic-Quellen sie investieren und welche Content-Formate am besten konvertieren. Jede dieser Entscheidungen profitiert von Signifikanztests.
Beispiel-Workflow: Ein Publisher testet zwei Versionen eines Testartikels – eine mit einer Vergleichstabelle oben, eine mit der Tabelle unten. Bei 10.000 Seitenaufrufen erzielt die Version mit der Tabelle oben eine Klickrate von 3,1 % zum Händler gegenüber 2,6 % für die Platzierung unten. Ein Chi-Quadrat-Test ergibt p = 0,04. Der Publisher übernimmt das Format mit der Tabelle oben und wendet das Muster auf andere Testberichte an.
Für Affiliate-Programm-Manager
Programm-Manager bewerten die Partnerleistung, legen Provisionsstufen fest und entscheiden, welche Affiliates angeworben oder gehalten werden sollen. Statistische Signifikanz hilft dabei, konstant leistungsstarke Partner von denen zu unterscheiden, deren gute Monate lediglich auf Varianz zurückzuführen sind.
Beispiel-Workflow: Ein Programm-Manager vergleicht zwei Affiliates mit ähnlichem Traffic-Volumen. Affiliate A hat eine Konversionsrate von 5,2 % über 12 Monate; Affiliate B hat 4,1 %. Ein Zwei-Stichproben-z-Test bestätigt, dass der Unterschied signifikant ist (p = 0,008). Der Manager nutzt diese Daten, um Affiliate A höhere Provisionsstufen zuzuweisen und zu untersuchen, was Affiliate B verbessern könnte.
In allen drei Rollen gilt das gleiche Prinzip: Lassen Sie die Daten die Signifikanz erreichen, bevor Sie handeln. Voreilige Entscheidungen – Provisionen für einen Partner erhöhen, der einen guten Monat hatte, oder eine Landingpage aufgeben, die eine schlechte Woche hatte – gehören zu den häufigsten und vermeidbarsten Fehlern im Affiliate-Marketing.
Grenzen und häufige Missverständnisse
Signifikant ≠ wichtig
Dies ist das hartnäckigste Missverständnis. Ein Ergebnis kann bei p < 0,001 statistisch signifikant und dennoch zu klein sein, um relevant zu sein. In einem bekannten Beispiel aus dem NIST Engineering Statistics Handbook war eine Verbesserung des Fertigungsprozesses statistisch signifikant, brachte aber nur einen Gewinn von 0,2 Einheiten – weit unterhalb der Schwelle des praktischen Nutzens.
Stellen Sie immer zwei Fragen:
- Ist es statistisch signifikant? (der p-Wert)
- Ist der Effekt groß genug, um relevant zu sein? (die Effektstärke)
P-Hacking und die Reproduzierbarkeitskrise
P-Hacking bezeichnet die Praxis, mehrere Analysen durchzuführen und nur diejenigen selektiv zu berichten, die Signifikanz erreichen. Häufige Formen sind:
- Viele Metriken testen und diejenige hervorheben, die „gewinnt"
- Die Datenerhebung stoppen, sobald p die 0,05-Schwelle überschreitet
- Ausreißer nachträglich ausschließen, um den p-Wert zu drücken
Diese Praktiken erhöhen die Falsch-Positiv-Rate dramatisch.
Die Lehre für Geschäftsanwender: Registrieren Sie Ihren Testplan vorab, bleiben Sie bei einer primären Metrik und widerstehen Sie der Versuchung, nach Signifikanz zu fischen.
Wann man sich nicht auf statistische Signifikanz verlassen sollte
Statistische Signifikanz ist in folgenden Szenarien weniger nützlich – oder sogar irreführend:
- Sehr kleine Stichproben: Bei weniger als 100 Beobachtungen pro Gruppe erreichen nur enorme Effekte die Signifikanz. Negative Ergebnisse sind nicht aussagekräftig, kein Beleg für das Fehlen eines Effekts.
- Mehrere gleichzeitige Änderungen: Wenn Sie fünf Elemente einer Seite auf einmal ändern, kann ein signifikantes Ergebnis nicht sagen, welche Änderung den Effekt verursacht hat.
- Erkundungsarbeiten mit geringem Risiko: Nicht jede Entscheidung erfordert einen formellen Signifikanztest. Für die frühe Erkundungsphase können richtungsweisende Daten ausreichen.